12 dk okuma
Gemma 4 ile Hukuk Bürosu Testi: Sonuçlar
Gemma 4'ü tek RTX 3090'da, kurgusal belgelerle altı hukuk bürosu işinde denedik. Model sözleşmedeki on değişikliğin dokuzunu buldu, kaynaklı soruların tamamını doğru cevapladı; bir cevapta ikinci dayanağı göstermedi. Düşünme açıkken 18 denemenin yedisi cevap yazmadan bitti; hukuki yorumun doğruluğunu ölçmedik.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
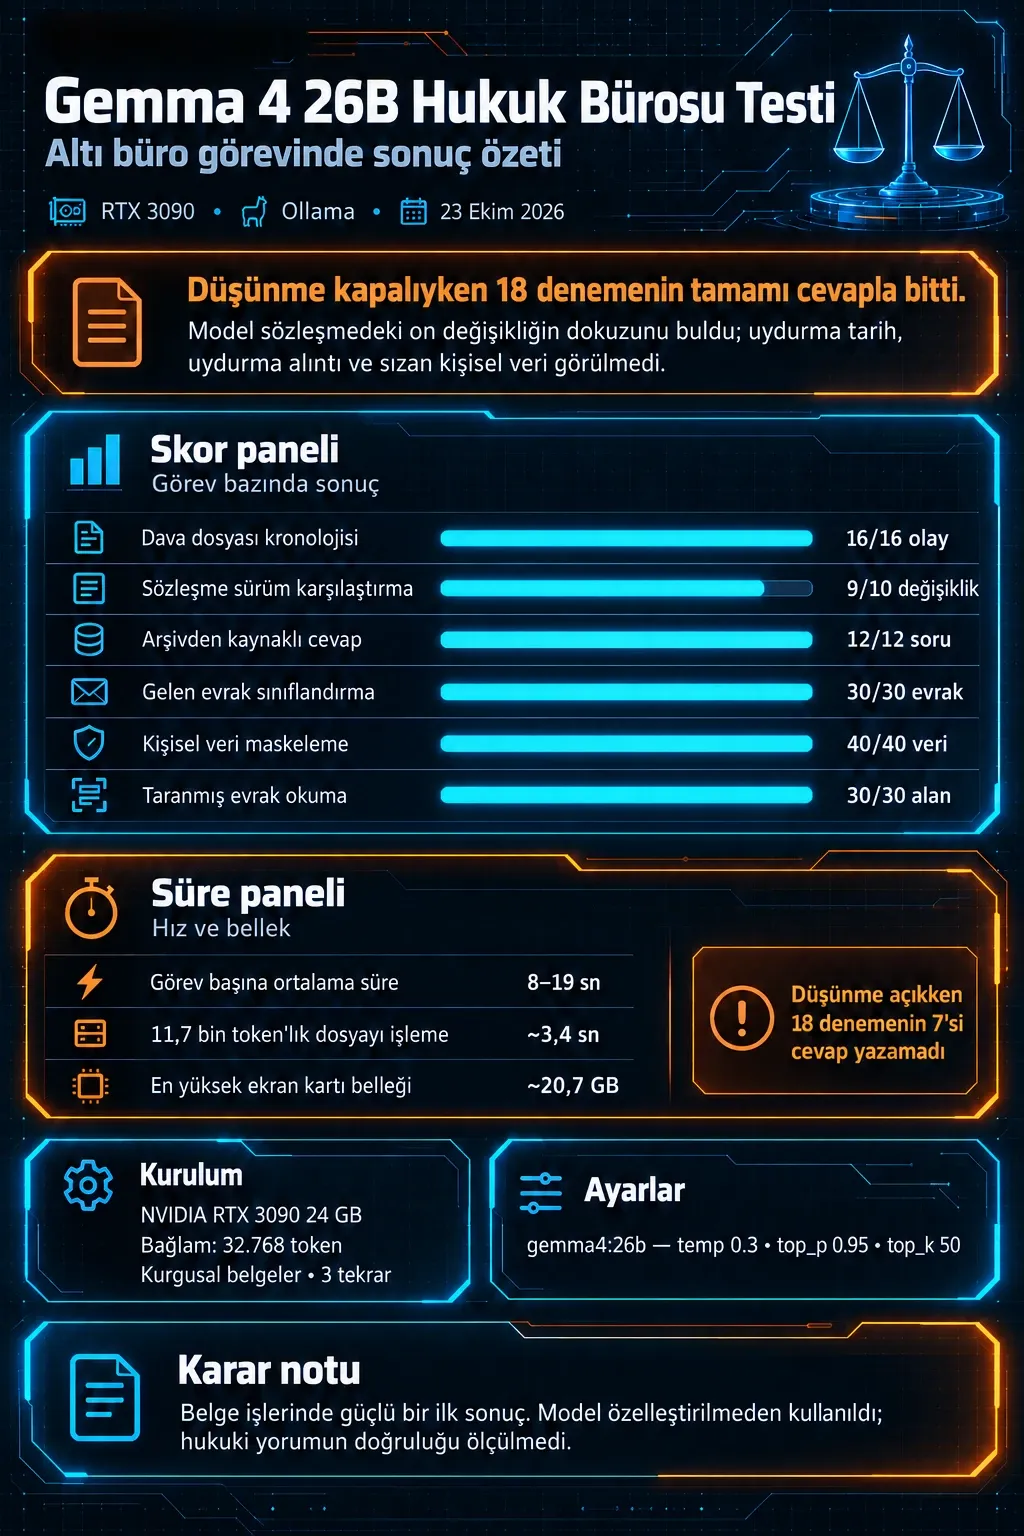
- Düşünme kapalıyken 18 denemenin tamamı cevapla bitti. Görev başına ortalama süre yaklaşık 8–19 saniyeydi; ekran kartında en yüksek bellek kullanımı yaklaşık 20,7 GB oldu.
- Model sözleşmedeki on değişikliğin dokuzunu buldu. Bir yazım düzeltmesini kaçırdı; bulduğu ve/veya değişikliğini ise testte beklenenin aksine biçimsel saydı.
- Modeli büroya özel eğitmedik veya bir arama sistemine bağlamadık. Özelleştirmenin bu sonuçları nasıl değiştireceğini ölçmedik.
Gemma 4 hukuk bürosu işlerinde ne yaptı?
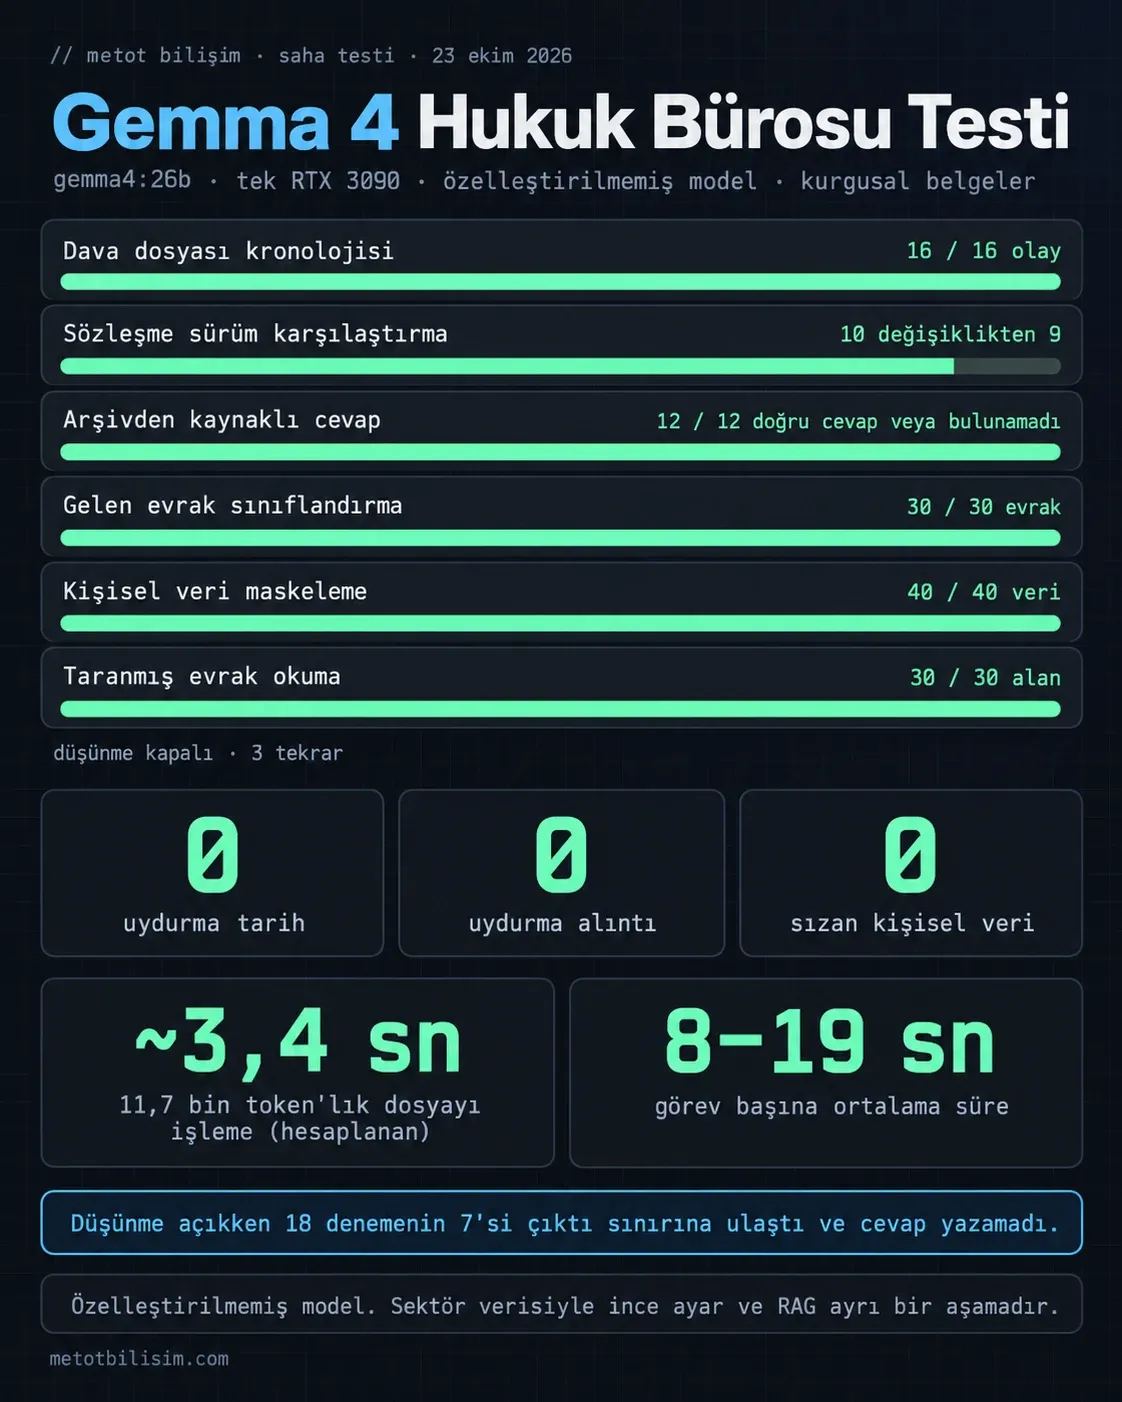
#Gemma 4, düşünme kapalıyken 16 olayın tarihini doğru çıkardı, 30 evrakı doğru sınıflandırdı ve beş taranmış evraktaki 30 alanı doğru okudu. Sözleşmedeki on değişikliğin dokuzunu buldu. Kaynaklı soruların tamamını doğru cevapladı, ancak bir cevapta ikinci dayanağı göstermedi. Maskelemede aranan kişisel verilerin hiçbiri çıktıda kalmadı.
Testi 23 Ekim 2026’da, gemma4:26b paketiyle tek RTX 3090’da yaptık. Altı görevin her birini düşünme açık ve kapalı olarak üçer kez denedik. Böylece toplam 36 model çağrısı, yani modele gönderilen 36 ayrı istek oluştu.
Düşünme kapalıyken üç tekrarın sonuçları
Dava dosyası kronolojisi
Sonuç16/16 olay tarihiUydurma tarih yok
Sözleşme karşılaştırma
Sonuç9/10 değişiklikYanlış alarm yok
Kaynaklı soru-cevap
Sonuç12/12 doğru cevap veya bulunamadı yanıtıBir tekrarda ikinci dayanak eksik
Gelen evrak sınıflandırma
Sonuç30/30 evrakSüreli evrak kaçmadı
Kişisel veri maskeleme
Sonuç40/40 veri öğesiTam veya kısmi sızıntı yok
Taranmış evrak okuma
Sonuç30/30 alanBulanık evrak dahil
Tablodaki sonuçlar farklı kontrollerden geliyor. Örneğin cevap puanı tam olsa da kaynak listesi eksik kalabiliyor; her görevin ayrıntısını aşağıda açıklıyoruz.
Bu deneme, hukuk büroları için yerel yapay zekâ kurulumu sayfasındaki işlere ait ölçümleri sunuyor. Belgeleri büro içinde işlemek isteyen bir yöneticinin, hangi çıktıları kontrol etmesi gerektiğini de gösteriyor.
Testi hangi ayarlarla yaptık?
#Modeli, yerel modelleri çalıştıran Ollama programı üzerinden, 24 GB bellekli RTX 3090’da çalıştırdık. Modele genel davranış kuralları veren ayrı bir sistem istemi göndermedik.
Token, modelin metni işlerken kullandığı, kelimenin tamamı veya bir kısmı olabilen küçük parçadır. Bağlam penceresi, girdi, düşünme ve cevabın bir seferde sığabildiği toplam alandır. Sıcaklık, cevap üretilirken yapılan seçimlerin değişkenliğini belirler. top_p ve top_k, sıradaki parça için değerlendirilen seçenekleri olasılık ve sayı bakımından sınırlar.
| Ayar | Değer |
|---|---|
| Sıcaklık | 0,3 |
| top_p / top_k | 0,95 / 50 |
| Bağlam penceresi | 32.768 token |
| Çıktı sınırı, düşünme kapalı | 8.192 token |
| Çıktı sınırı, düşünme açık | 16.384 token; düşünme ve cevap birlikte |
| Tekrar | 6 görev × 2 mod × 3 tekrar = 36 çağrı |
| İstenen cevap biçimi | Her görevde tek JSON nesnesi |
JSON, bilgileri adlandırılmış alanlarda tutan bir metin biçimidir. Bu biçim, cevapları programla karşılaştırmamızı sağladı. Düşünme modu ise modelin nihai cevaptan önce ayrı bir düşünme metni üretmesidir.
Belgeleri programlar üretti; olay, değişiklik ve kişisel veri listelerini önceden tanımladık. Kişiler, kurumlar, dosya numaraları, IBAN’lar ve telefonlar kurgusaldı. T.C. kimlik numaralarının doğrulama hanesi de geçersizdi. Puanlayıcı, cevapları önceden hazırlanan listelerle otomatik karşılaştırdı.
Bu turda görev girdileri en çok yaklaşık 11,7 bin token tuttu. Önceki testteki 80 bin tokenlık arşivde modelin zorlanmasını Gemma 4 ve LFM2.5 karşılaştırmasında anlatmıştık.
| Görev | Verilen belge | Kontrol edilen çıktı |
|---|---|---|
| Kronoloji | Altı belge türünden oluşan ticari alacak dosyası; belgeler karışık sırada | 16 olay tarihi, sıra, belge ve üç yanıltıcı tarih |
| Sözleşme karşılaştırma | Hizmet sözleşmesinin iki sürümü | On değişikliğin yeri, türü ve önem etiketi |
| Kaynaklı soru-cevap | Sekiz belge; dokuzu cevaplanabilir toplam 12 soru | Cevap, kaynak listesi ve alıntı |
| Evrak sınıflandırma | Sekiz türden 30 kısa evrak | Tür, dosya numarası ve süreli olup olmadığı |
| Maskeleme | 40 kişisel veri ve korunacak altı öğe | Sızıntı, gereksiz silme, etiketler ve kalan metin |
| Görselden okuma | Beş evrak görseli | Her evrakta altı alan |
Altı görevin ayrıntılarında ne gördük?
#En belirgin eksikler sözleşmedeki değişiklikleri değerlendirmede ve cevapların bütün dayanaklarını göstermede çıktı. Aşağıdaki sonuçlar, düşünme kapalı moddaki üç tekrara ait.
Dava dosyasındaki tarihler doğru sıralandı
Model, 16 olayın tarihini üç tekrarda da eksiksiz ve doğru sırayla listeledi. Gösterdiği belgeler de tarihlerin geçtiği belgelerle eşleşti. Belgelerde olmayan bir tarih yazmadı.
Türk Borçlar Kanunu ile Türk Ticaret Kanunu’nun Resmî Gazete yayım tarihleri ve başka bir dosyadan aktarılan emsal karar tarihi de metindeydi. Model bu üç tarihi davanın olayı olarak listelemedi.
Tarihleri bulma ve yanlış tarih eklememe ölçütlerini birleştiren F1 puanı 1,00 oldu. Puanlayıcı olay açıklamalarının anlamını ayrıca değerlendirmiyor; tarih, sıra ve belge eşleşmesini kontrol ediyor.
Girdi yaklaşık 11,7 bin token idi. Sayfa başına 400 token varsayımıyla bu, yaklaşık 29 sayfaya karşılık geliyor. Okuma hızı üzerinden hesaplanan işleme süresi yaklaşık 3,4 saniye, bütün görevin ortalama süresi 8,5 saniyeydi.
Sözleşmede bir yazım düzeltmesi kaçtı
Model on değişikliğin dokuzunu buldu ve olmayan bir değişikliği var diye işaretlemedi. Değişikliğin maddesini ve türünü birlikte değerlendiren F1 puanı üç tekrarda da yaklaşık 0,947 çıktı.
Dört ince değişikliğin tamamını yakaladı: ödeme süresinin 30 günden 15 güne inmesi, “ve” yerine “veya” yazılması, ceza oranının %10’dan %20’ye çıkması ve yetkili mahkemenin değişmesi.
Cevap doğruydu, dayanaklardan biri eksikti
Model dokuz sorunun cevabını buldu; arşivde cevabı olmayan üç soruyu da “bulunamadı” diye işaretledi. Üç tekrarda verdiği toplam 27 alıntının tamamı arşivde birebir vardı.
Kaynak listesi ilk tekrarda cevaplanabilir dokuz sorunun sekizinde tamdı. Sonraki iki tekrarda dokuzunun da kaynakları tamdı. Böylece ortalama 8,67 oldu; bu sayı, bir sorunun kısmen cevaplandığı anlamına gelmiyor.
Eksik dayanak, işi geciktiren alt yükleniciyle ilgili davanın sorumlu avukatını soran cevapta görüldü. Bilirkişi raporu hangi davada gecikme olduğunu, büro içi not ise o davanın sorumlu avukatını gösteriyordu. Model doğru avukatı yazdı ama kaynak listesine yalnızca iç notu koydu; bilirkişi raporunu eklemedi.
Gelen evrakların türü ve süre bilgisi doğruydu
Model, 30 evrakın türünü, dosya numarasını ve süreli olup olmadığını üç tekrarda da doğru çıkardı. Süreli bir evrakı atlamadı; süresiz evrakı da süreli diye işaretlemedi. Seçebileceği sekiz evrak türü vardı.
Kişisel veriler maskelendi, kalan metin çok az değişti
Model 40 veri öğesinin tamamını maskeledi. Bunlar dokuz türdeydi: ad-soyad, T.C. kimlik numarası, telefon, e-posta, adres, IBAN, plaka, doğum tarihi ve iş yeri adı. Aynı metnin üç tekrarında toplam 120 öğeden hiçbiri çıktıda kalmadı. Soyadı veya sokak adı gibi kısmi sızıntı da görülmedi.
Korunması istenen altı öğe yerinde kaldı: mahkeme adı, kanun maddesi, dosya esas numarası, “Av.” unvanı, kamu kurumu adı ve dava tarihi. Aynı kişi her geçtiğinde aynı etiketi aldı.
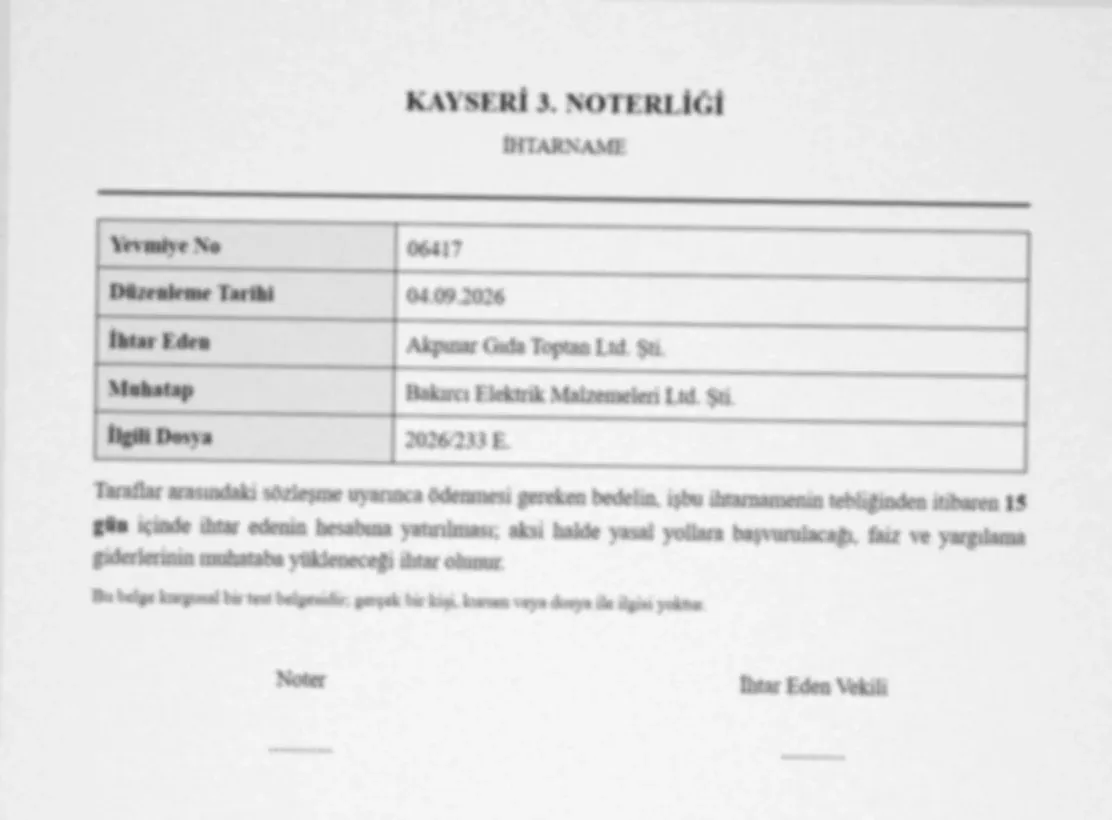
Bulanık ihtarnamedeki altı alan da okundu
Model, beş evraktaki toplam 30 alanı doğru çıkardı. Belgeler tebligat, icra emri, duruşma zaptının ilk sayfası, ihtarname ve masraf makbuzuydu.
Görsellere hafif döndürme, gri ton ve gürültü uygulandı; ihtarname ayrıca bulanıklaştırıldı. Her birinde evrak türü, mahkeme veya daire, dosya numarası, tarih, taraf adı ve süre veya tutar istendi. Bulanık ihtarnamenin altı alanı da doğruydu.
Düşünme açıkken neden cevap yazılamadı?
#Yedi denemede model, ortak çıktı sınırını doldurdu ve nihai cevap yazamadan durdu. Açık modda düşünme ve cevap için toplam 16.384 token ayrılmıştı. Bu yedi kaydın tamamında üretilen toplam bu sınıra ulaştı; durma nedeni length, yani uzunluk sınırıydı.
Düşünme açıkken 18 denemenin yedisi cevapsız kaldı
Her modda altı görev üçer kez denendi.
- Cevap yazdı
- Çıktı sınırında cevapsız durdu
Düşünme kapalı
Düşünme açık
Tablo olarak göster
| Mod | Cevap yazdı | Çıktı sınırında cevapsız durdu |
|---|---|---|
| Düşünme kapalı | 18 | 0 |
| Düşünme açık | 11 | 7 |
Maskelemenin üç tekrarında da cevap boş kaldı. Kronoloji, sözleşme karşılaştırma, kaynaklı soru-cevap ve sınıflandırmada birer deneme cevapsız bitti. Taranmış evrak görevinde üç cevap da tamamlandı.
Maskelemenin düşünme metninde aynı etiketleri yeniden kontrol eden çok sayıda “bir kez daha kontrol” notu vardı. Bu kayıt, modelin cevap öncesinde ne yazdığını gösteriyor; görevi bilip bilmediğini ölçmüyor.
Düşünme açıkken görevlerin ortalama süresi uzadı
Üç tekrarın ortalaması; yükleme ve cevapsız denemelerin süreleri dahil. Değerler aynı ölçekte okunabilsin diye bütün hücrelerde dakika ve saniye birimi kullanıldı.
- Düşünme kapalı
- Düşünme açık
Kronoloji
Sözleşme karşılaştırma
Kaynaklı soru-cevap
Evrak sınıflandırma
Kişisel veri maskeleme
Taranmış evrak
Tablo olarak göster
| Görev | Düşünme kapalı | Düşünme açık |
|---|---|---|
| Kronoloji | 0 dk 9 sn | 1 dk 7 sn |
| Sözleşme karşılaştırma | 0 dk 11 sn | 1 dk 10 sn |
| Kaynaklı soru-cevap | 0 dk 8 sn | 1 dk 12 sn |
| Evrak sınıflandırma | 0 dk 10 sn | 1 dk 5 sn |
| Kişisel veri maskeleme | 0 dk 19 sn | 1 dk 26 sn |
| Taranmış evrak | 0 dk 10 sn | 0 dk 22 sn |
Grafikte süreleri en yakın saniyeye yuvarladık. Kapalı modun yuvarlamadan önceki görev ortalamaları sırasıyla 8,5, 11,2, 7,7, 9,9, 19,0 ve 9,7 saniyeydi. Açık modda aynı sıra 1 dakika 7 saniye, 1 dakika 10,1 saniye ve 1 dakika 11,9 saniyeyle başladı. Kalan ortalamalar 1 dakika 5,4 saniye, 1 dakika 25,8 saniye ve 21,8 saniyeydi.
Cevap yazılan beş görevde ana puanın iki mod arasındaki farkı 0,000 oldu. Maskelemede açık moddan puanlanabilir cevap gelmediği için bu karşılaştırmayı yapamıyoruz. Kaynaklı cevapların kaynak listesi ise açık modda puanlanan iki denemede de tamdı. Ana puanın aynı olması, bütün alt ölçümlerin aynı olduğu anlamına gelmiyor.
Tek RTX 3090 yeterli oldu mu?
#Evet, bu testte model tamamen ekran kartında çalıştı. Tüm kartın en yüksek bellek kullanımı yaklaşık 20,7 GB oldu; masaüstünün kullandığı bellek de bu ölçüme dahil. VRAM, ekran kartının kendi belleğidir.
Okuma ve yazma ayrı ölçümler. Aşağıdaki okuma ortalaması metin görevlerine ait; taranmış evrakların görsel işleme hızını kapsamıyor. Önceki girdiden yararlanarak hızlanan çağrılar da okuma ortalamasının dışında tutuldu.
| Ölçüm | Değer |
|---|---|
| Metin okuma ortalaması | Saniyede yaklaşık 3.274 token |
| Kronoloji girdisinin hesaplanan okuma süresi | Yaklaşık 3,4 sn; 11,7 bin token |
| MTP açık, düşünme kapalı yazma ortalaması | Saniyede yaklaşık 204 token |
| MTP açık, düşünme açık yazma ortalaması | Saniyede yaklaşık 197 token |
| En yüksek VRAM | Yaklaşık 20,7 GB; tüm kart |
| Kapalı modda görev ortalamaları | Yaklaşık 8–19 sn |
| 36 çağrının süreleri toplamı | Yaklaşık 22 dk 24 sn |
Toplam süre, çağrı sürelerinin toplamıdır. Oturumlar arasındaki beklemeler bu toplama dahil değil. Kronolojideki 3,4 saniye de ayrı bir kronometre ölçümü değil; girdi uzunluğunun okuma hızına bölünmesiyle hesaplandı.
Bu test hangi soruları cevaplamıyor?
#Test, gerçek dava dosyalarında hukuki yorumun doğruluğunu veya bir büronun bütün iş yükünü ölçmüyor. Tek model ve tek donanımda, doğru cevapları önceden bilinen kurgusal belgelerle yapılmış bir mühendislik denemesi.
Sözleşmede değişikliği bulma, önemini etiketleme ve hukuki sonucunu yorumlama ayrı işler. Bu testte ilk ikisi için kontroller var; üçüncüsü için bir doğruluk puanı yok.
Özelleştirme bu sonuçları değiştirir mi?
#Bu testten özelleştirmenin etkisini çıkaramıyoruz; modelin yayımlanan hâlini kullandık. İnce ayar, modeli ek örneklerle eğiterek uyarlamaktır. RAG, cevap için gereken belgeleri bir arama sistemiyle bulup modele sunmaktır. İkisini de kullanmadık; kaynaklı soru-cevapta sekiz belgenin tamamı soruyla birlikte verildi.
Büroya özel şablon ve terim sözlüğü de kullanılmadı. Metot Bilişim olarak modeli büronuzun ya da sektörünüzün kendi verisiyle ince ayar ve RAG kullanarak uyarlıyoruz. Bu testte gördüğümüz zayıflıklar, uyarlamanın hedefini gösteriyor: büronun esaslı saydığı değişiklikleri tanımak, cevabı her dayanak belgeye bağlamak ve büronun diliyle yazmak. Uyarlamanın bu sonuçları ne kadar değiştirdiğini bu testte ölçmedik; her büroda kendi örnek belgeleriyle, doğru cevabı baştan bilinen görevlerle ölçmek gerekir. Kurulum ve kapsam yerel yapay zekâ kurulumu sayfasında.
Çıktılarda hangi kontroller öne çıkıyor?
#Kaynak listesi ve değişikliğin önem etiketi, bu testte somut eksik gördüğümüz iki alan. Maskelemenin kapsamı ve cevabın tamamlanıp tamamlanmadığı da ayrı kontroller gerektiriyor.
Cevap tamamlandı mı bakın:
Kapalı modda bütün denemeler cevapla bitti. Açık modda yedi cevap boş kaldı; daha yüksek çıktı sınırını denemedik.
Cevabın bütün dayanaklarını kontrol edin:
Sorumlu avukat doğru yazıldığı hâlde, davayı belirleyen bilirkişi raporu ilk tekrardaki kaynak listesinde yoktu.
Bulunan değişikliğin önemini ayrıca değerlendirin:
Model “ve/veya” farkını gördü ama testte esaslı sayılan değişikliği biçimsel etiketledi.
Maskelemenin neyi kapsadığını kontrol edin:
Ölçülen 40 veri öğesi dokuz türden geliyor. Bu sonuç, kişinin olayın ayrıntılarından tanınmasını ölçmüyor.
TBB’nin avukatlar için yapay zekâ tavsiye rehberi, anonimleştirilmiş belge özeti ve sözleşme karşılaştırmasını sınırlı ve kontrollü kullanımlar arasında ele alıyor. Bu grupta maskeleme, onaylı araç, insan denetimi, kayıt, ikinci göz incelemesi ve gerekirse müvekkil bilgilendirmesi sayılıyor. Rehberde nihai hukuki değerlendirme ve sorumluluk avukata ait. Risk gruplarını hukuk büroları sayfasında ele alıyoruz.
Testi kendi bilgisayarımda nasıl tekrarlarım?
#Depoyu bilgisayarınıza kopyalayıp README’deki kurulum adımlarını izleyin; önce puanlayıcıyı sınayan selftest.py, sonra modeli çalıştıran run_legal.py kullanılıyor. Yeni bir deneme için --tag ile farklı bir sonuç klasörü adı verin. Aksi hâlde koşucu, depoda zaten bulunan kayıtları görüp bu denemeleri atlıyor.
// açık test verisi
- kod · MIT
- veri · CC BY 4.0
metotbilisim/yerel-yz-hukuk-testi
github.com
Senaryolar, belgeler, doğru cevaplar ve başarısız denemeler açık
Altı görevin girdileri ve sonuçları depoda bulunuyor. Cevap yazılamayan yedi çağrının kayıtları da korunuyor; maskelemenin üç cevapsız tekrarı buna dahil.
// depoda neler var
Test senaryosu:
TASARIM.md, görevlerin istemlerini, puan tanımlarını ve sınırlarını anlatıyor. Belgeleri üreten programlargen/klasöründe.Kurgusal belgeler:
Dava dosyası, sözleşme sürümleri, büro arşivi, evraklar, 40 kişisel verilik metin ve taranmış evrak görselleri.
Doğru cevaplar:
Her görevin
gold.jsondosyası, puanlayıcının karşılaştırdığı cevapları içeriyor.Çalıştırma ve puanlama:
grade.py,selftest.pyverun_legal.pybulunuyor.regrade.py, kayıtlı cevapları modele yeniden sormadan puanlıyor.Ham sonuçlar:
36 çağrının cevap dosyaları, düşünme metinleri ve puan dökümleri bulunuyor. Cevapsız çağrıların cevap dosyaları boş.
git clone https://github.com/metotbilisim/yerel-yz-hukuk-testi.gitKod MIT, test verileri CC BY 4.0 lisansıyla yayımlanıyor. Verileri kullanırken kaynak olarak Metot Bilişim (metotbilisim.com) belirtin.
Kaynaklar
#Testin dışındaki rehber ve model bilgileri için yazıda kullanılan bağlantılar aşağıda.
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinYerel yapay zekâ hukuk bürosunda kullanılabilir mi?
Bu test, altı işteki sonuçları gösteriyor. Model 16 olayın tarihini, 30 evrakın sınıfını ve beş görseldeki 30 alanı doğru çıkardı. Sözleşmedeki on değişikliğin dokuzunu buldu; kaynaklı cevaplardan birinde ikinci belge eksikti. Hukuki yorumun doğruluğunu ölçmedik.
Gemma 4 dava dosyasından kronoloji çıkarabilir mi?
Kurgusal dosyamızdaki 16 olayın tarihini, sırasını ve belge bilgisini doğru çıkardı. Dosyanın olayı olmayan üç tarihi listeye almadı. Girdi yaklaşık 11,7 bin token tuttu; token, modelin işlediği küçük metin parçasıdır. Okuma için hesaplanan süre yaklaşık 3,4 saniye, görevin ortalama süresi 8,5 saniyeydi.
Yerel model kişisel veriyi maskeleyebilir mi?
Testteki 40 veri öğesinin tamamını maskeledi. Aynı metnin üç tekrarında toplam 120 öğeden hiçbiri tam veya kısmi olarak çıktıda kalmadı. Korunması istenen altı öğeyi silmedi ve aynı kişiye aynı etiketi verdi. Tarih, tutar ve olayın birlikte kişiyi tanıtıp tanıtmadığını ölçmedik.
Düşünme modu açık mı olmalı?
Bu koşuda kapalı moddaki 18 denemenin tamamı cevapla bitti; açık modda yedisi cevapsız kaldı. Açık modda düşünme ve cevap için ortak sınır 16.384 token idi. Cevap veren görevlerde ana puan yükselmedi. Daha büyük bir çıktı sınırını denemedik.
Hukuk bürosu için hangi donanım yeter?
Bu kurulumda 24 GB bellekli tek RTX 3090 yetti. Model tamamen ekran kartında çalıştı; masaüstünün kullanımı dahil en yüksek bellek yaklaşık 20,7 GB oldu. Daha küçük kartları veya aynı anda birden fazla kullanıcıyı denemedik.
Özelleştirme neyi değiştirir?
Bu testte etkisini ölçmedik. Modeli ek eğitimle uyarlamadık, büroya özel şablon veya terim sözlüğü kullanmadık. Belgeleri arama sistemiyle bulmak yerine doğrudan soruyla birlikte verdik.
Gemma 4 hukuki görüş verebilir mi?
Bu test bu soruyu cevaplamıyor. Tarih çıkarma, değişiklik bulma, kaynaklı cevap, sınıflandırma, maskeleme ve görselden alan okuma işlerini ölçtük. Hukuki yorumun doğruluğu puanlamanın dışında kaldı.
Test belgeleri gerçek müvekkil verisi miydi?
Hayır. Kişi ve kurum adları, dosya numaraları, T.C. kimlik numaraları, IBAN'lar ve telefonlar kurgusaldı. T.C. kimlik numaralarının doğrulama hanesi geçersizdi. Belgeleri, doğru cevapları önceden tanımlayan programlar üretti.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Hukuk Büroları İçin Yerel Yapay Zekâ Kurulumu
Müvekkil dosyalarını büronuzun kendi sunucusunda işleyen yerel yapay zekâ kurulumu: TBB rehberiyle ilişkisi, erişim ayrımı ve sağlayıcı seçim soruları.
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen lokal (yerel) yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.