23 dk okuma
Gemma 4 vs LFM2.5: Yerel Yapay Zekâ Testi
İki yerel yapay zekâ modelini, gemma4:26b ile lfm2.5-24b-a2b'yi, tek RTX 3090 ekran kartında 73 çalıştırmayla kod yazma, otonom proje ve uzun doküman görevlerinde karşılaştırdık. gemma4:26b açık farkla kazandı: 220 gizli kod testinin ortalama %83,2'sini geçti, lfm2.5 %46,8'de kaldı. Farkın ana nedeni düşünme bütçesi: lfm2.5 birçok denemede cevap yazmadan önce bütçeyi bitirdi.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- gemma4:26b kod yazmada (%83,2'ye karşı %46,8), tek başına proje yürütmede (%95'e karşı %49) ve uzun metinde daha tutarlı çıktı.
- lfm2.5-24b-a2b daha az bellek kullanıyor, metni yaklaşık iki kat hızlı okuyor ve kısa, iyi tanımlı görevlerde yeterli; ama zor işte düşünme bütçesini bitirip cevapsız kalabiliyor.
- Yerel model seçerken kıyaslama tablosuna değil, kendi işinizin gizli testlerine ve modelin ne zaman düşünmeyi bırakacağına bakın.
Gemma 4 mü LFM2.5 mi: testin kısa sonucu nedir?
#Testimizde gemma4:26b 220 gizli kod testinin ortalama %83,2’sini geçti; lfm2.5-24b-a2b %46,8’inde kaldı. Aynı iki model, 35 gizli kabul testli otonom proje görevinde %95’e karşı %49 aldı. Bu yazıdaki test rakamlarının tamamı, 19 Ekim 2026’da tek bir RTX 3090 ekran kartında yaptığımız toplam 73 model çalıştırmasından geliyor.
Kod testi başarısı
lfm2.5%47gemma4%83220 gizli test
Proje görevi başarısı
lfm2.5%49gemma4%9535 kabul testi
Projeyi bitirme süresi
lfm2.521,6 dkgemma45,5 dkdüşük olan iyi
Yazma hızı
lfm2.5222 token/sngemma4216 token/snneredeyse eşit
Farkın ana nedeni düşünme bütçesi. Düşünen bir akıl yürütme modeli cevap yazmadan önce uzun bir iç ses üretir; bu iç sesin token sınırı bitince model cevap veremez. lfm2.5 altı kod görevinden üçünde bu yüzden ya da çalışmayan dosya yüzünden hiç puan alamadı. gemma4 de bütçeyi üç denemede bitirdi, ama bunlar 18 denemenin yalnızca üçüydü.
lfm2.5’in gerçek avantajları da var. Daha az bellek kullanıyor, metni yaklaşık iki kat hızlı okuyor ve kısa, iyi tanımlı görevlerde yeterli: Roma rakamları görevinde 64 testin 64’ünü, üç denemede de geçti. Yazma hızında iki model neredeyse eşit çıktı. Ama bu avantajlar zor işte doğruluğa dönüşmedi.
Bu iki modeli aynı tüketici ekran kartında, modelin hiç görmediği otomatik testlerle C#, JavaScript, PHP ve ajan görevinde karşılaştıran yayımlanmış başka bir test bulamadık (araştırma: 22 Ekim 2026). Üretici tablolarına ve Türkçe kaynaklara da baktık; ayrıntısı “Sonuçlarımız üretici ve bağımsız testlerle örtüşüyor mu?” bölümünde.
Neden yerel yapay zekâ modellerini test ettik?
#Yerel model, kendi bilgisayarınızda veya sunucunuzda çalışan modeldir. Bulut asistanlarında yazdığınız metin üreticinin sunucusuna gider; yerel modelde veri makineden çıkmaz ve ücret yerine elektrik harcarsınız. Bu iki fark, müşteri belgeleri veya kaynak kod gibi hassas veriyle çalışan işletmeler için ilgi çekici.
Asıl soru başka: bir model kâğıt üstünde iyi görünse de gerçek işi yapıyor mu? Üreticilerin yayımladığı kıyaslamalar bize modelin soru-cevapta, matematikte veya genel bilgide ne kadar iyi olduğunu söylüyor. Bir BT yöneticisinin ya da yazılımcının sorusu ise daha somut: “Bu model benim bozuk modülümü bulur mu? Bir sipariş yazılımındaki hatayı kimse yardım etmeden düzeltir mi? 200 sayfalık arşivde doğru kişiyi bulur mu?”
Bu soruları sınamak için kendi testimizi kurduk. Testin özgünlüğü dört şeyden geliyor.
- Puanı hakem değil gizli testler veriyor: modelin hiç görmediği, yazdığı kodu otomatik çalıştıran testler.
- Görevlerden birine bilinçli bir kültür tuzağı koyduk (Türkçe bölgesel ayar, tr-TR).
- Modele tek başına çalışacağı bir ajan görevi, yani bir yazılım projesi verdik.
- 200 sayfalık bir arşiv üzerinde çok parçalı sorular sorduk.
Bulut asistanına veri yüklemenin kendi sınırları var; bunun için yapay zekâ ile veri analizi rehberimize bakabilirsiniz. Bu yazı ise yerel seçeneği ölçüyor: aynı donanımda, aynı ayarlarla, iki modelin karşılaştırması.
Test düzeneği nasıl kuruldu?
#Testlerin tamamı tek bir masaüstü bilgisayarda çalıştı. Ekran kartı, 24 GB VRAM’e (ekran kartı belleği) sahip bir NVIDIA RTX 3090; modeller ayrı bir diskte duruyordu. Ekran kartında aynı anda yalnızca tek model çalıştı, böylece biri diğerinin belleğini veya hızını etkilemedi.
| Bileşen | Ayrıntı |
|---|---|
| Ekran kartı | NVIDIA RTX 3090, 24 GB |
| İşlemci | Intel Core i5-12600K (10 çekirdek, 16 iş parçacığı) |
| Bellek | 32 GB RAM |
| Çalıştırma yazılımı | Ollama 0.40.6, Windows 10 |
| Tarih | 19 Ekim 2026 |
Süreyi Ollama’nın zaman sayaçlarıyla, düşünme ve cevap yazma sürelerini akış sırasında ayrı ayrı ölçtük. Bellek ve gücü nvidia-smi ile aldık. Model yapı bilgilerini model dosyalarının kendi üst verisinden okuduk. Hiçbir testte işlemciye taşma olmadı; iki model de baştan sona ekran kartında çalıştı.
gemma4 uzun dokümanda 22,9 GB’a çıktı; lfm2.5 18,2 GB’da kaldı
Testler sırasında ölçtüğümüz en yüksek ekran kartı belleği (GB).
- lfm2.5
- gemma4
- referans: kartın kapasitesi (24 GB)
Kod testi
Proje görevi
Uzun doküman~80 bin token
Tablo olarak göster
| Test | lfm2.5 | gemma4 |
|---|---|---|
| Kod testi | 16,0 | 20,2 |
| Proje görevi | 17,0 | 21,5 |
| Uzun doküman (~80 bin token) | 18,2 | 22,9 |
Bellek farkı pratik bir sonuç doğuruyor. lfm2.5 aynı kartta daha fazla boşluk bırakıyor; uzun bağlam veya ikinci bir iş için yer kalıyor. gemma4 uzun dokümanda 22,9 GB’a çıkıyor, yani 24 GB’lık kartta payı dar.
Yarışmacılar: LFM2.5 ve Gemma 4 nasıl modeller?
#İki modelin ortak yanı, ikisinin de uzmanlar karışımı (MoE, Mixture of Experts) olması. Böyle bir model, her token için ağın tamamını değil yalnızca birkaç uzman alt ağını çalıştırır. Token, modelin metni işlediği birimdir; yaklaşık bir kelimenin dörtte üçü eder. Toplam parametre sayısı modelin boyutunu, aktif parametre sayısı her token’da gerçekten çalışan kısmı gösterir. İkisi de açık ağırlıklı model: ağırlıkları Hugging Face’te yayımlanmış ve kendi donanımınızda çalıştırılabiliyor.
LFM2.5-24B-A2B, Liquid AI’ın LFM ailesinden. Model kartına göre 24,0 milyar toplam, yaklaşık 2,45 milyar aktif parametresi var. 40 katmanın 30’u çift kapılı kısa konvolüsyon bloğu, 10’u dikkat bloğu (GQA); yani hibrit bir mimari. MoE bloğunda 64 uzmandan 4’ü çalışıyor. Bağlam penceresi, yani modelin tek seferde görebildiği metin miktarı, 131.072 token. Lisansı LFM Open License v1.0. En önemli davranış farkı: kart, bunun yalnızca düşünen (reasoning-only) bir model olduğunu söylüyor; her zaman önce düşünüyor.
Gemma 4 26B-A4B, Google’ın Gemma ailesinin 4. kuşağı. Kartına göre 25,2 milyar toplam, 3,8 milyar aktif parametresi var; Ollama sayfası “4 milyar aktif” diyor. 30 katman, 128 uzmandan 8’i artı 1 paylaşılan uzman çalışıyor. Dikkat katmanlarında 1024 token’lık kayan pencere ve global dikkat dönüşümlü; son katman global. Bağlam 256 bin token, Apache 2.0 lisanslı ve görüntü de anlıyor. Düşünme sistem isteminin başındaki <|think|> ile açılıp kapanıyor.
lfm2.5-24b-a2b: her token’da 64 uzmandan 4’ü çalışır
gemma4:26b: her token’da 128 uzmandan 8’i çalışır
Yani gemma4 her token’da daha fazla parametre çalıştırıyor ve bellekte daha fazla yer tutuyor. lfm2.5 daha hafif. Ama token başına iş hafif olsa da toplam iş hafif olmadı: lfm2.5 bu testte görev başına çok daha fazla token harcadı.
| lfm2.5-24b-a2b | gemma4:26b | |
|---|---|---|
| Geliştirici | Liquid AI | |
| Parametre (toplam · aktif) | 24 milyar · ~2 milyar | 25,2 milyar · ~4 milyar |
| Uzman | 64’ten 4’ü | 128’den 8’i |
| Katman | 40 | 30 |
| Dosya boyutu (bizim paket) | 14 GB (4-bit kuantizasyon) | 18 GB (4-bit kuantizasyon) |
| Bağlam | 128 bin token | 256 bin token |
| Yetenek | düşünme, araç kullanma | düşünme, araç kullanma, görüntü |
| Düşünme | her zaman açık | açılıp kapanıyor |
Bir uyarı: testte kullandığımız lfm2.5-24b-a2b paketi, topluluk tarafından Ollama’ya yüklenmiş bir sürümdü. Ollama’nın resmi lfm2.5:24b paketi 15 GB, Q4_K_M ve Liquid AI yayıncısı altında; iki paketin aynı olup olmadığını karşılaştırmadık. Resmi paketin önerilen ayarları (sıcaklık 0,1, top_k 50) bizim ayarlarımızdan farklı; bunu “Yöntem notu ve sınırlar” bölümünde ayrıca ele alıyoruz.
Yöntem: hakem neden insan değil, gizli testler?
#Yapay zekâ çıktısını insan okuyarak puanlamak yavaş ve tutarsız. Biz her görev için gizli testler yazdık. Modele yalnızca görev metni ve arayüz verildi; testleri görmedi. Modelin yazdığı kod çıkarıldı, test projesine konuldu ve otomatik çalıştırıldı. Puan, geçen testlerin oranıdır.
Görev verilir:
Model, görev metnini ve istenen arayüzü alır.
Model düşünür:
Cevap yazmadan önce iç ses üretir; bu aşama düşünme bütçesinden harcar.
Kod çıkarılır:
Modelin cevabındaki kod otomatik ayıklanır ve test projesine yerleştirilir.
Gizli testler çalışır:
Model yazarken görmediği testler çalıştırılır; sonuç geçen test sayısıdır.
Sonuçları biz okuruz:
Puanı biz vermeyiz; yalnızca testlerin ürettiği sonuçları yorumlarız.
Bu yöntemin iki sonucu var. Birincisi, “modelin cevabı güzel görünüyor” yetmez; kod derlenmiyorsa veya testi geçmiyorsa puan sıfırdır. İkincisi, iki model de aynı düzenekte, aynı koşullarda ölçüldü. İki modelde de şu ayarlar aynıydı.
- Sıcaklık 0,3 (modelin cevaplardaki rastgelelik ayarı)
- Düşünme modu açık
- Kod ve proje görevleri 3 kez, uzun doküman görevi 2 kez çalıştırıldı
- Ekran kartında aynı anda yalnızca tek model
- Görevler İngilizce verildi; iki modele de aynı metin
- Düşünme için token bütçesi var; bütçe bitince model cevap veremez
Bütçe sınırı kod ve proje görevlerinde 24.576 token, uzun doküman görevinde 32 bin token’dı. Bu sınırlar sonuçları doğrudan etkiliyor; bütçeyi bitiren model, ne kadar iyi bilirse bilsin sıfır alıyor.
1. raunt: hangi model daha iyi kod yazıyor?
#Birinci rauntta altı görev, üç dil ve toplam 220 gizli test vardı. Her görevi her model üç kez denedi, yani her modelde 18 deneme. gemma4 altı görevin dördünde tüm gizli testleri geçti; lfm2.5 üç görevde hiç puan alamadı.
| Görev | Dil | Gizli test |
|---|---|---|
| Hesap makinesi motoru (ifade ayrıştırıcı) | C# .NET 10 | 39 |
| Geri alınabilir veri deposu (iç içe işlem) | C# .NET 10 | 24 |
| İş havuzu ve yeniden deneme | JavaScript Node 24 | 25 |
| Hata avı: 12 gizli hatalı modül | JavaScript Node 24 | 42 |
| Katı Roma rakamları | PHP 8.4 | 64 |
| Süreli LRU önbellek | PHP 8.4 | 26 |
İki dilde zorluk farklı yerlerden geldi: C# görevleri uzun ve kurallı bir tasarım, PHP önbelleği ise dilin kendi sınırlarını bilmeyi istiyordu. Sonuçlar görev görev şöyle dağıldı.
gemma4 altı görevin dördünde tüm gizli testleri geçti; lfm2.5 üç görevde hiç puan alamadı
Geçilen gizli testlerin oranı, 3 denemenin ortalaması. Genel ortalama: lfm2.5 %46,8, gemma4 %83,2.
- lfm2.5
- gemma4
C# hesap makinesi
C# veri deposu
JS iş havuzu
JS hata avı
PHP Roma rakamları
PHP süreli önbellek
Tablo olarak göster
| Görev | lfm2.5 | gemma4 |
|---|---|---|
| C# hesap makinesi | %0 | %65,8 |
| C# veri deposu | %0 | %100 |
| JS iş havuzu | %97,3 | %100 |
| JS hata avı | %83,3 | %100 |
| PHP Roma rakamları | %100 | %100 |
| PHP süreli önbellek | %0 | %33,3 |
Görevleri dil dil anlatalım.
C#: hesap makinesi ve veri deposu
Hesap makinesinde modelden, metin olarak verilen bir matematik ifadesini hazır değerlendirici kullanmadan çözmesini istedik. DataTable.Compute, Roslyn ve harici kütüphane yasaktı. Dört işlem, üs (^), parantez ve tekli eksi/artı destekleniyordu. Kurallar küçük ama sinsi: ^ sağdan birleşir, tekli eksi ^’den zayıftır.
2^3^2  = 512
-2^2   = -4
2^-1   = 0.5
39 testin 24’ü doğru sonuç, 13’ü FormatException (boş metin, 2+, *3, (), 2 3, 1.2.3, eksik parantez, 3**2, 2+a, 2,5+1), 2’si DivideByZeroException bekliyordu. Tuzak şuydu: testler Türkçe kültür ayarında (tr-TR) çalışıyor; sayıyı kültüre bağlı okuyan kod “3.5”i 35 sanıyor. gemma4 üç denemenin birinde bütçeyi bitirdi, ikisinde 38/39 ve 39/39 aldı; lfm2.5 üç denemede de bütçeyi bitirdi.
Veri deposu görevi, bellekte çalışan ve iç içe işlem (BEGIN/ROLLBACK/COMMIT) destekleyen bir anahtar-değer deposuydu; Get, Set, Delete ve Count işlemleri O(1) olmalıydı. 24 testin biri performans testiydi: 200 bin anahtar ve 1.000 iç içe işlemle toplam 3 saniyenin altı. gemma4 üç denemede de 24/24 aldı; lfm2.5 üç denemede de bütçeyi bitirdi.
JavaScript: iş havuzu ve hata avı
İş havuzu görevi, aynı anda en fazla N işi çalıştıran bir havuz ve artan beklemeli yeniden deneme mantığıydı; harici paket yasaktı. Yeniden deneme testi 40 ms ardından 80 ms bekleme süresini ölçüyordu. gemma4 üç denemede 25/25 aldı; lfm2.5 23/25, 25/25 ve 25/25.
Hata avında yorum satırlarında ne yapması gerektiği yazan bir modülde 12 gizli hata vardı; modele kaç hata olduğunu söylemedik: parseQuery 4, deepEqual 4, debounce 3, chunk 1, groupBy hatasız. Dokunulmamış modül 42 testin 22’sini zaten geçiyordu. gemma4 üç denemede de 42/42 aldı; lfm2.5 üç denemede de 35/42’de takıldı.
18 denemenin akıbeti
lfm2.5’in 9 sıfırının 6’sı cevapsız (düşünme bütçesi bitti), 3’ü çalışmayan dosya. gemma4’ün 3 sıfırı da cevapsız.
- Tam puan
- Kısmi puan
- Sıfır
lfm2.5
gemma4
Tablo olarak göster
| Model | Tam puan | Kısmi puan | Sıfır |
|---|---|---|---|
| lfm2.5 | 5 | 4 | 9 |
| gemma4 | 14 | 1 | 3 |
PHP: Roma rakamları ve süreli önbellek
Roma rakamları görevinde yalnızca standart yazım geçerliydi (IIII, IC, VX hatalıdır) ve 1–3999 aralığı destekleniyordu. 64 testin 28’i bilinen değerler, biri 1’den 3999’a gidiş-dönüş, 29’u reddedilmesi gereken girdilerdi. İki model de üç denemede 64/64 aldı. lfm2.5’in hafif ve hızlı yapısı, böyle kısa ve iyi tanımlı görevde yetiyor.
Süreli LRU önbellek, dolunca en uzun süredir kullanılmayanı atan ve süre aşımı (TTL) olan bir önbellekti; zaman dışarıdan enjekte edilen bir saatle yönetiliyordu. 26 test vardı. gemma4 iki denemede bütçeyi bitirdi, birinde 26/26 aldı. lfm2.5 üç denemede de dosyayı çalıştıramadı.
lfm2.5 iki C# görevinde bütçenin tamamını harcadı; gemma4 yalnızca PHP önbellekte tavana dayandı
Görev başına harcanan token (düşünme ve cevap toplamı), 3 denemenin ortancası. Bütçe sınırı 24.576 token.
- lfm2.5
- gemma4
- referans: düşünme bütçesi (24.576 token)
C# hesap makinesi
C# veri deposu
JS iş havuzu
JS hata avı
PHP Roma rakamları
PHP süreli önbellek
Tablo olarak göster
| Görev | lfm2.5 | gemma4 |
|---|---|---|
| C# hesap makinesi | 24.576 | 19.950 |
| C# veri deposu | 24.576 | 9.191 |
| JS iş havuzu | 15.189 | 6.874 |
| JS hata avı | 11.118 | 8.605 |
| PHP Roma rakamları | 6.796 | 8.173 |
| PHP süreli önbellek | 16.924 | 24.576 |
Grafiğin gösterdiği şey: lfm2.5’in ortancası iki C# görevinde bütçenin tavanına dayandı; gemma4’ün ortancası yalnızca PHP önbellek görevinde tavana ulaştı. Roma rakamlarında ise gemma4 biraz daha fazla token harcadı; bu tek görevde lfm2.5 daha tasarruflu.
Üç başarısızlık hikâyesi
Sayıların ardındaki davranış, çoğu zaman rakamlardan daha öğretici.
lfm2.5 · C# hesap makinesi
98 bin karakterlik bir iç ses üretti ve sıfır satır kod yazdı. Düşünme kayıtlarında aynı test senaryosunu (“–2 sonucu kaç?”) defalarca baştan hesapladığı görülüyor. Bütçe bitince cevap boş kaldı.
lfm2.5 · PHP süreli önbellek
Üç denemede de sınıfın içine private class Node koydu. Bu yapı C# ve Java’da var, PHP’de yok. Dosya hiç açılmadı (sözdizimi hatası).
gemma4 · C# hesap makinesi
38 testi geçti, ama birinde “2+a” gibi hatalı girdide kendini sonsuza kadar çağırıp programı çökertti. Kusursuz değildi; yine de tamamladığı denemeler lfm2.5’in hiçbir denemesinden çok daha ileriydi.
PHP hatasının kalıbı kabaca şöyle; PHP iç içe sınıf tanımını desteklemediği için dosya yüklenmeden çöküyor.
class LruCache
{
    private class Node   // PHP'de sınıf içinde sınıf tanımlanamaz
    {
        // ...
    }
}
Bütçeyi iki katına çıkarınca ne oldu?
lfm2.5’in sorunu yalnız süre mi, yoksa kod kalitesi mi? Bunu ayırmak için iki C# görevini 49 bin token’lık bütçeyle, yani iki katıyla yeniden denedik. lfm2.5 bu kez cevap yazdı, ama 4 denemenin 2’sinde kod derlenmedi; diğer ikisi 35/39 ve 8/24 aldı. gemma4 veri deposunda yine iki denemede 24/24 aldı. Sonuç: lfm2.5’in sorunu yalnızca süre değil, kod kalitesi de.
2. raunt: model projeyi tek başına bitirebiliyor mu?
#İkinci rauntta modeli yapay zekâ ajanı olarak çalıştırdık. Ajan, tek bir cevap yazmakla yetinmeyip araç kullanarak adım adım iş yapan modeldir. Görev, gerçekçi bir sipariş yönetim yazılımıydı: 7 kaynak dosya ve 8 bin token’lık bir şartname.
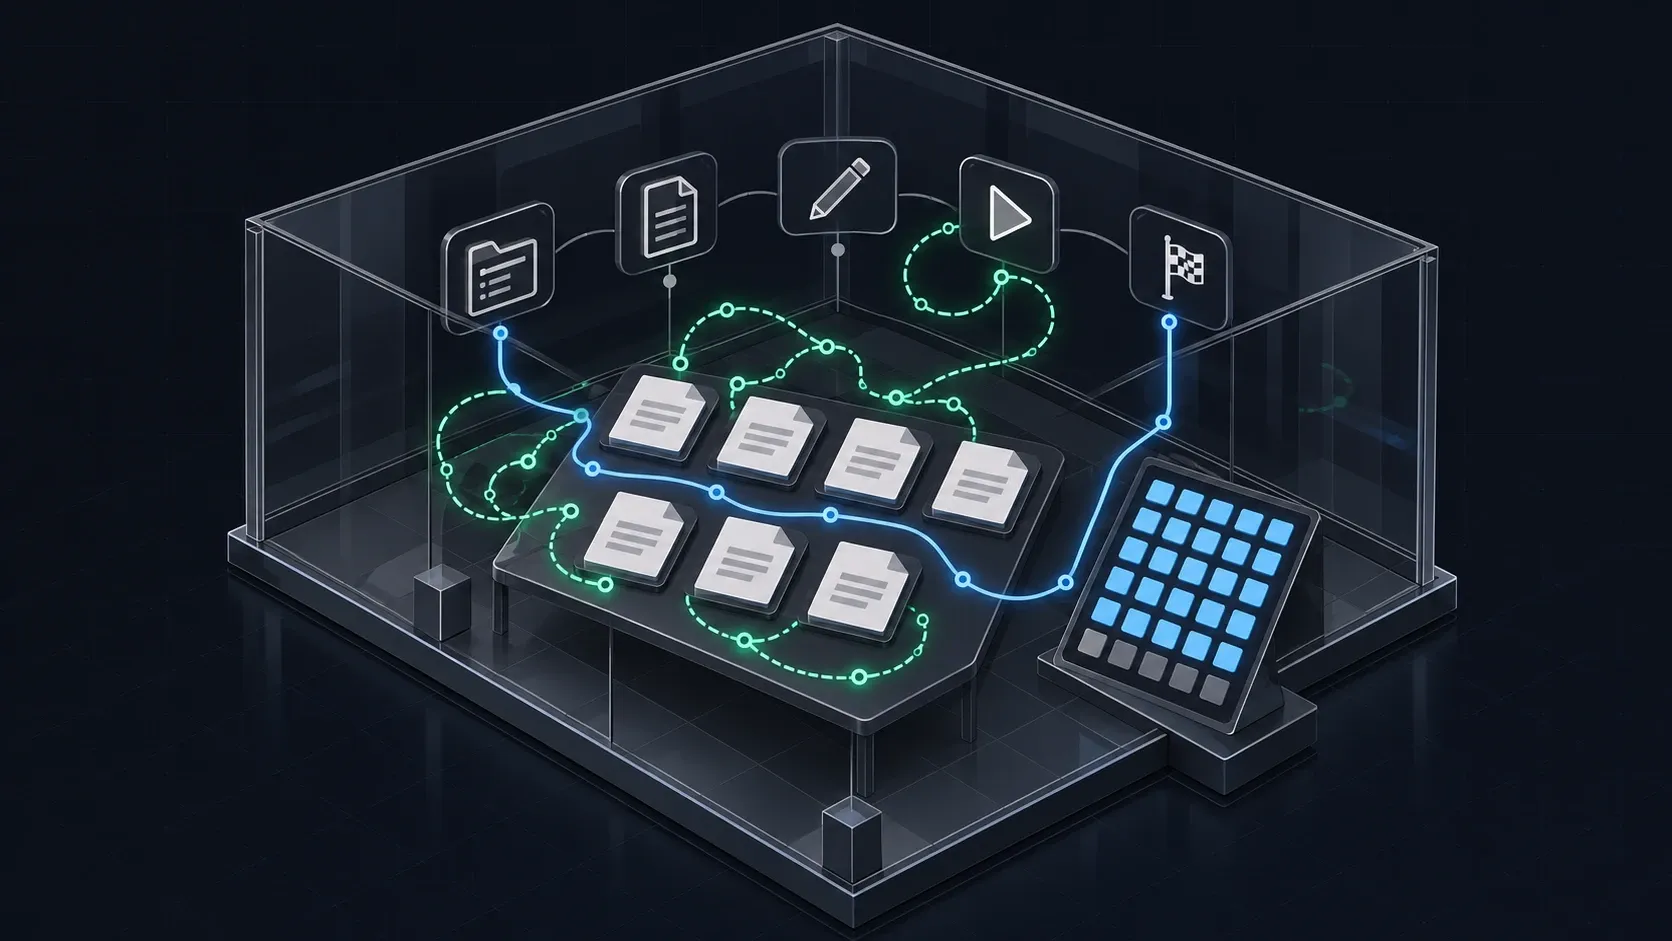
Dört hata raporu kullanıcı şikâyeti biçimindeydi: “kupon fazla indirim yapıyor”, “başarısız siparişten sonra stok kayboluyor”, “kupon bir gün erken bitiyor”, “indirim satırlara garip dağılıyor”. Bunların üstüne sıfırdan bir özellik eklenecekti: yuvarlama kuralları, stok iadesi ve rapor değişiklikleriyle kısmi iade. Model beş aracı kullanabiliyordu: dosyaları listele, oku, yaz, testleri çalıştır ve “bitti” de. 60 adım sınırı vardı ve soru soracak kimse yoktu.
Puanı 35 gizli kabul testi verdi. Dokunulmamış proje bunların 11’ini zaten geçiyordu; yani kimse hiçbir şey yapmasa 11/35 elde edilirdi.
gemma4 üç denemenin üçünde de projeyi bitirdi, lfm2.5 ikisinde adım sınırına takıldı
Her denemede geçilen gizli kabul testi sayısı (35 üzerinden). Genel başarı oranı: gemma4 %95, lfm2.5 %49.
- lfm2.5
- gemma4
- referans: dokunulmamış proje (11/35)
Deneme 1lfm2.5 48 adım, gemma4 24 adım
Deneme 2lfm2.5 60 adım, gemma4 33 adım
Deneme 3lfm2.5 60 adım, gemma4 27 adım
Tablo olarak göster
| Deneme | lfm2.5 | gemma4 |
|---|---|---|
| Deneme 1 (lfm2.5 48 adım, gemma4 24 adım) | 23/35 | 33/35 |
| Deneme 2 (lfm2.5 60 adım, gemma4 33 adım) | 19/35 | 32/35 |
| Deneme 3 (lfm2.5 60 adım, gemma4 27 adım) | 10/35 | 35/35 |
lfm2.5’in üçüncü denemesindeki 10/35, dokunulmamış projenin 11/35’inin de altında. Yani modelin müdahalesi, o denemede çalışan bir kısmı bozdu.
Hangi sorunun ne kadar çözüldüğüne de baktık: 3 denemede ilgili gizli testlerin geçilme oranı.
lfm2.5 hataların çoğunu kısmen çözdü, ama yeni özellikte %19’da kaldı
Sorun bazında geçilen gizli test oranı, 3 denemenin ortalaması.
- lfm2.5
- gemma4
Kupon KDV hatası
Kaybolan stok
Erken biten kupon
İndirim dağıtımı
Yeni özellik: kısmi iade
Eski özellikleri bozmamak
Tablo olarak göster
| Sorun | lfm2.5 | gemma4 |
|---|---|---|
| Kupon KDV hatası | %67 | %100 |
| Kaybolan stok | %83 | %100 |
| Erken biten kupon | %67 | %100 |
| İndirim dağıtımı | %72 | %100 |
| Yeni özellik: kısmi iade | %19 | %90 |
| Eski özellikleri bozmamak | %87 | %100 |
En büyük uçurum yeni özellikte. Hata düzeltmek, var olan kodu okuyup küçük bir değişiklik yapmayı gerektirir. Kısmi iade ise şartnameyi okuyup birkaç dosyayı tutarlı biçimde değiştirmeyi, yuvarlama ve stok kurallarını birlikte düşünmeyi gerektirir. lfm2.5 en çok bu işte zorlandı.
Ortalama bitirme süresi lfm2.5’te 21,6 dakika, gemma4’te 5,5 dakika
Her deneme için proje görevinin süresi (dakika).
- lfm2.5
- gemma4
Deneme 1
Deneme 2
Deneme 3
Tablo olarak göster
| Deneme | lfm2.5 | gemma4 |
|---|---|---|
| Deneme 1 | 20,4 | 4,5 |
| Deneme 2 | 24,5 | 7,1 |
| Deneme 3 | 20,0 | 5,0 |
lfm2.5 yazma hızında gemma4’e denk olduğu için süre farkı hız farkından değil, çok daha fazla adım atmasından geliyor. İki modelin çalışma biçimi şöyle ayrıştı.
gemma4: planlı çalışma
Okuma:
Dosya listesini, şikâyetleri ve şartnameyi baştan sona okudu.
Düzeltme:
Her hatanın kaynağını buldu, hedefli düzeltmeler yaptı ve iade özelliğini şartnameye göre yazdı.
Doğrulama:
Testleri 5 kez çalıştırdı ve sonuçları gördükten sonra “bitti” dedi.
Teslim:
24–33 adımda tamamladı; bağlam yaklaşık 17–24 bin token’da kaldı.
lfm2.5: deneme yanılma
Okuma:
Dosyaları okudu ve düzeltmelere hemen başladı.
Düzeltme:
Aynı dosyaları tekrar tekrar baştan yazdı.
Doğrulama:
Testleri 16–25 kez çalıştırdı; deneme yanılmaya girdi.
Teslim:
İki denemede adım sınırına takıldı, birinde çalışan kodu bozdu; 48–60 adım atıldı ve bağlam yaklaşık 56–77 bin token’a şişti.
Bu, düşünme bütçesi hikâyesinin ajan görevindeki karşılığı: lfm2.5 bağlamı şişirdi, aynı dosyaları yeniden yazdı ve adım bütçesini tüketti. Bunun nedenini sınamadık; gözlemimiz yalnızca bu sırayla yaşandığı.
3. raunt: 200 sayfalık arşivde model neyi hatırlıyor?
#Üçüncü rauntta uzun metin hafızasını sınadık. Hayali bir lojistik şirketinin bir yıllık arşivini hazırladık: personel listesi, birbirini geçersiz kılan duyurular (tayinler, yönetici değişiklikleri, harcırah zamları, işten ayrılışlar), yüzlerce masraf kaydı ve dikkat dağıtan alakasız toplantı notları.
İki boyutun her birinde 10 soru sorduk; her soru birkaç parçayı birleştirmeyi gerektiriyordu. Örnekler: “Nisan’daki zamdan sonra İzmir harcırah limitini aşan masraflar hangileri?”, “Bu çalışanın genel müdüre kadar yönetici zinciri nedir?”, “Şubat’ta iptal edilen kodun yerine geçen güncel kod hangisi?” Düşünme bütçesini bu rauntta 32 bin token yaptık.
Düşünerek yanıtlarda çoğu hücre boş: iki model de bütçeyi masraf defterini saymakla bitirdi
Doğru cevap puanı (10 üzerinden). “cevap yok”: model bütçeyi bitirdi, cevap yazamadı.
- lfm2.5
- gemma4
- referans: tam puan (10/10)
~75 sayfadüşünerek, 1. deneme
~75 sayfadüşünerek, 2. deneme
~200 sayfadüşünerek, 1. deneme
~200 sayfadüşünerek, 2. deneme
Tablo olarak göster
| Arşiv | lfm2.5 | gemma4 |
|---|---|---|
| ~75 sayfa (düşünerek, 1. deneme) | cevap yok | cevap yok |
| ~75 sayfa (düşünerek, 2. deneme) | cevap yok | 9,0 |
| ~200 sayfa (düşünerek, 1. deneme) | 1,2 | cevap yok |
| ~200 sayfa (düşünerek, 2. deneme) | 1,0 | cevap yok |
İki model de aynı tuzağa düştü: yüzlerce satırlık masraf defterini akıllarından satır satır saymaya kalktılar ve bütçe bitti. gemma4 30 bin token’lık arşivde bütçeyi bir kez yetiştirdi ve 10 sorunun 9’unu doğru cevapladı: yönetici zinciri, tarihe göre değişen limit, çeyreklik toplam ve iptal edilen kod doğru geldi. Ama aynı arşivde ilk denemede cevapsız kaldı. 200 sayfalık arşivde gemma4 iki denemede de cevap yazamadı.
Düşünmeyi kapatınca ne oluyor? Bunu gemma4’te “doğrudan cevap ver” ayarıyla denedik. lfm2.5’in düşünmesi bu ayarla kapanmıyor.
Düşünme kapalıyken gemma4 her iki arşivde cevap verdi, ama 10 sorudan en çok 4,2 puan aldı
Doğrudan cevap modunda puan (10 üzerinden).
- lfm2.5
- gemma4
- referans: tam puan (10/10)
~75 sayfadoğrudan cevap
~200 sayfadoğrudan cevap
Tablo olarak göster
| Arşiv | lfm2.5 | gemma4 |
|---|---|---|
| ~75 sayfa (doğrudan cevap) | cevap yok | 4,0 |
| ~200 sayfa (doğrudan cevap) | 1,1 | 4,2 |
gemma4 doğrudan cevapta 14–47 saniyede 10 sorudan 4 puan aldı. Basit bilgi bulmada hızlı ve isabetli, hesap gerektiren sorularda zayıf. lfm2.5 cevap verdiğinde neredeyse yalnızca “güncel kod” sorusunu bildi. Pratik sonuç: uzun bir arşivden toplam veya zincir gerektiren soru soracaksanız, modele satır saydırmak yerine bu işi koda veya arama aracına devretmek gerekir.
Hız, düşünme payı ve güç: teknik ölçümler ne gösterdi?
#Hız iki ayrı sayıdır. Okuma hızı (prompt işleme), modelin verdiğiniz metni ne kadar hızlı içeri aldığını; yazma hızı (üretim), cevabı ne kadar hızlı yazdığını gösterir. Uzun dokümanlarda okuma hızı belirleyicidir.
lfm2.5 metni yaklaşık iki kat hızlı okuyor
Okuma (prompt işleme) hızı, token/sn. Uzun doküman testi.
- lfm2.5
- gemma4
30 bin token metin
80 bin token metin
Tablo olarak göster
| Metin | lfm2.5 | gemma4 |
|---|---|---|
| 30 bin token metin | 7.209 | 3.467 |
| 80 bin token metin | 5.973 | 2.674 |
Bu, lfm2.5’in gerçek ve ölçülmüş avantajı: aynı uzun metni yaklaşık yarı sürede içeri alıyor. Ama cevap yazma hızında fark yok.
Yazma hızında iki model neredeyse eşit
Yazma (üretim) hızı, token/sn.
- lfm2.5
- gemma4
Kısa görevlerkod testi
Uzun bağlam~80 bin token
Tablo olarak göster
| Test | lfm2.5 | gemma4 |
|---|---|---|
| Kısa görevler (kod testi) | 222 | 216 |
| Uzun bağlam (~80 bin token) | 161 | 158 |
İki model de kısa görevlerde saniyede 200’ün üzerinde token yazdığı için süre farkı hızdan değil, harcanan token sayısından geliyor. Zamanın nereye gittiğine kod testlerinde ayrıca baktık.
İki modelin süresinin büyük kısmı düşünmeye gidiyor
Kod testlerinde sürenin düşünmeye ve cevap yazmaya giden payı (%).
- Düşünme
- Cevap yazma
lfm2.5
gemma4
Tablo olarak göster
| Model | Düşünme | Cevap yazma |
|---|---|---|
| lfm2.5 | 93,5 | 6,5 |
| gemma4 | 88,9 | 11,1 |
Kod testlerinde süre ağırlıklı olarak düşünmeye harcanıyor: lfm2.5’te %93,5, gemma4’te %88,9. Bu yüzden saniyedeki token sayısı tek başına model hızını anlatmıyor. Önemli olan, modelin kaç token’da bitirdiği.
| Ölçüt | lfm2.5 | gemma4 |
|---|---|---|
| Diskten yüklenme (ilk açılış) | 31 sn | 43 sn |
| İlk kelimeye kadar (model yüklüyken) | ~2,2 sn | ~2,5 sn |
| Ekran kartı gücü (çalışırken ort.) | ~364 W | ~365 W |
Ekran kartı çalışırken iki modelde de yaklaşık 365 W çekti. Yani lfm2.5’in token başına daha az parametre çalıştırması, bu donanımda elektrik tasarrufuna dönüşmedi; proje görevini yaklaşık dört kat uzun sürede bitirdiği için harcadığı enerji de muhtemelen daha yüksekti (enerjiyi ayrıca ölçmedik).
Sonuç: hangi model hangi iş için?
#gemma4:26b açık farkla kazandı. Kod yazmada, tek başına proje yürütmede ve uzun metinde daha doğru, daha tutarlı ve daha az israflı çalıştı. lfm2.5’in hafifliği ve okuma hızı gerçek avantaj, ama zor işte kaliteye dönüşmedi.
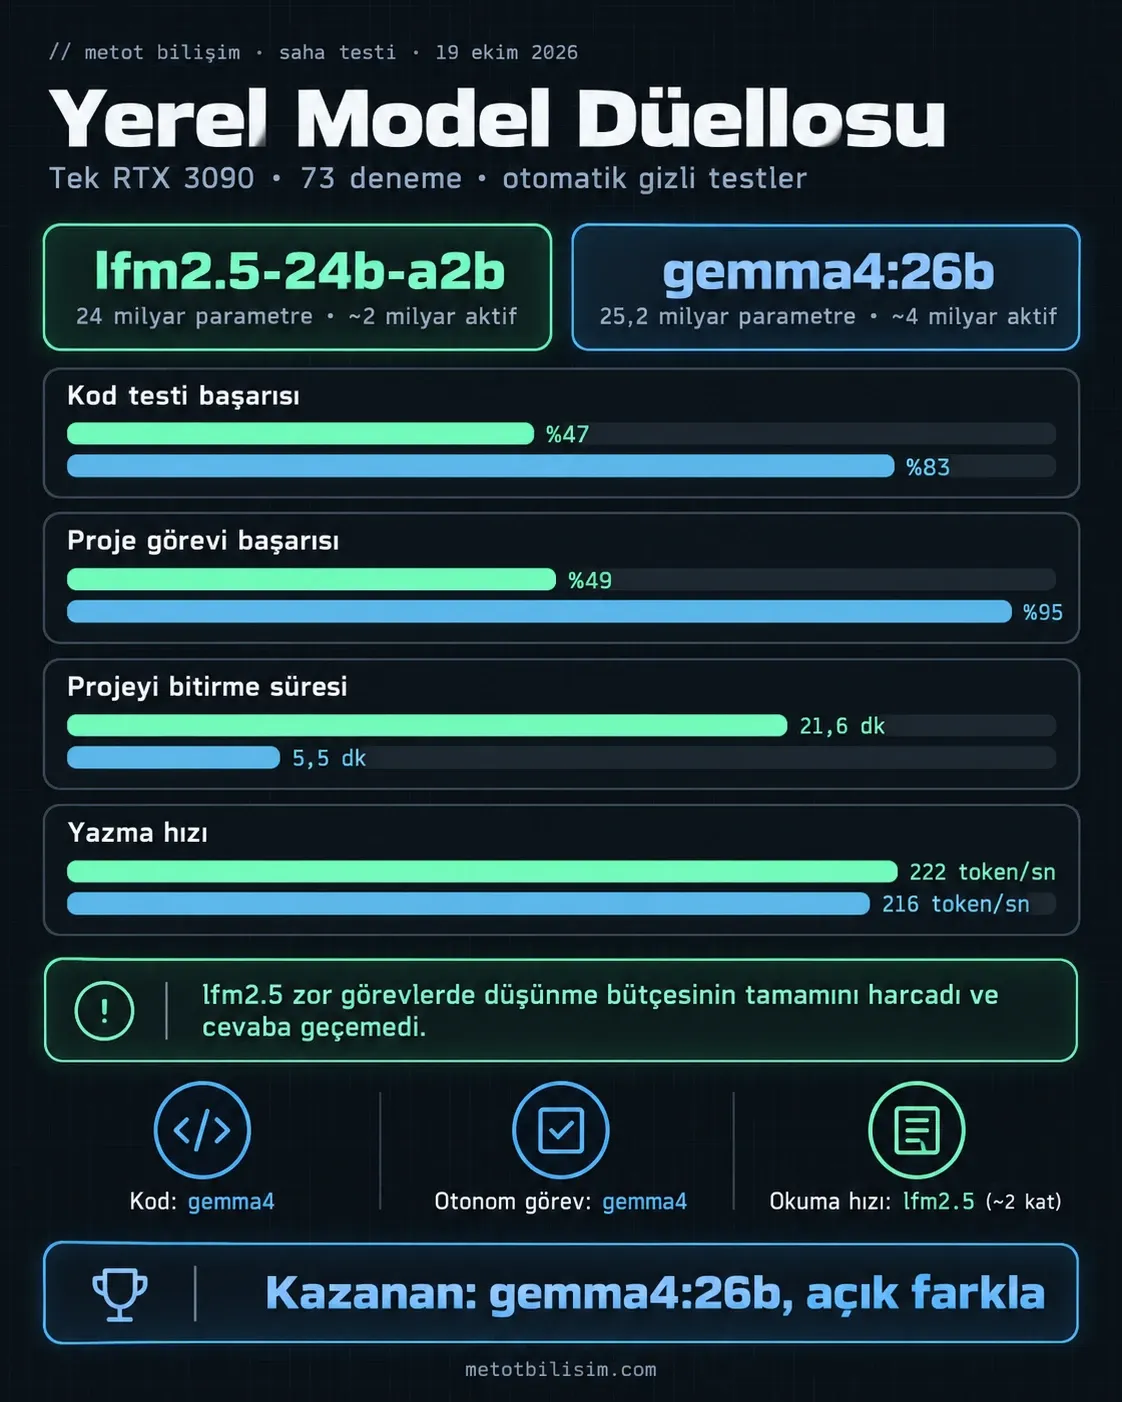
gemma4:26b ne için:
Günlük kodlamada C# ve JavaScript’te neredeyse kusursuz çalıştı. Tek başına görevde araçları disiplinli kullandı, işi bitirip teslim etti; üç denemenin üçünde de tamamladı. Çok zor görevlerde düşünme bütçesini 32–48 bin token’a çıkarmak işe yarıyor.
lfm2.5-24b-a2b ne için:
Hafif ve basit işlerde daha az bellek kullanıyor ve metni daha hızlı okuyor. Kısa ve iyi tanımlı görevlerde, Roma rakamları gibi, yeterli. Zor kod ve tek başına çalışma gerektiren işlerde bu testte güvenilir olmadı.
Bu testten çıkan genel ders şu: “düşünen” modellerde hız, saniyedeki token sayısından ibaret değil. Asıl mesele, modelin ne zaman düşünmeyi bırakıp cevaba geçeceğini bilmesi. Bu konuda gemma4 bizim testimizde çok daha olgun davrandı: daha az token harcayıp daha yüksek puan aldı ve bitirmesi gerektiğinde bitirdi.
Aşırı düşünme literatürde de bilinen bir sorun. Düşünme bloğunu token sınırında kapatıp cevabı zorlayan “budget forcing” yaklaşımı akademik çalışmalarda öneriliyor. Daha fazla düşünmenin her zaman daha iyi sonuç vermediğini, doğruluğun token sayısıyla düzgün artmadığını gösteren makaleler de var. “Bütçe bitince hiç cevap verememe” durumunu doğrudan inceleyen bir makale ise bulamadık; lfm2.5 her zaman düşündüğü için bu riskin yapısal olduğunu düşünüyoruz, ama bu bir yorum, kanıtlanmış bir sonuç değil.
Sonuçlarımız üretici ve bağımsız testlerle örtüşüyor mu?
#Kısmen. Kodlamada Google’ın yayımladığı sonuçlarla tutarlıyız; ajan ve araç kullanımında ise Liquid’in kendi tablosunun tersi bir sonuç aldık. Aşağıdaki tablo, kaynaklarda bulduklarımızla bizim ölçtüğümüzü yan yana koyuyor.
| Ölçüt | Üretici / bağımsız kaynak | Metot testi |
|---|---|---|
| Kodlama | Google, Gemma 4 26B-A4B için LiveCodeBench v6 %77,1 ve Codeforces ELO 1718 yayımlıyor; LFM2.5 için yayımlı karşılık bulamadık | 220 gizli testte gemma4 %83,2, lfm2.5 %46,8 |
| Gerçek yazılım görevi | Liquid’in kendi çalıştırmasında SWE-Bench Verified (OpenCode): LFM2.5 51,00, Gemma 25,80 | 35 testli proje görevinde gemma4 %95, lfm2.5 %49 |
| Araç çağırma | Liquid’in tablosunda BFCLv4 65,01 (LFM2.5) ve 57,09 (Gemma); ToolSandbox 80,71 ve 72,09 | Ayrı araç çağırma testi yapmadık; 5 araçlı ajan görevinde gemma4 üç denemeyi de bitirdi, lfm2.5 ikisinde adım sınırına takıldı |
| Talimat takibi | Liquid’in tablosunda IFEval 96,75 ve 92,00; IFBench 74,69 ve 47,44 (LFM2.5 ve Gemma) | Ölçmedik |
| Bilgi ve akıl yürütme | Google’ın kartında GPQA Diamond %82,3 (Gemma); Liquid’in koşusunda Gemma 74,90, LFM2.5 74,42 | Ölçmedik |
| Uzun bağlam | Google’ın kartında MRCR v2 8-needle 128k %44,1 (Gemma); LFM2.5 için yayımlı değer yok; bağlam 256K ve 128K | 200 sayfada gemma4 doğrudan cevapta 4,2, lfm2.5 1,1 puan (10 üzerinden); düşünürken ikisi de çoğunlukla cevapsız kaldı |
| Yazma hızı | Liquid’in kendi ölçümü: Apple M5 Max ~184 token/sn, AMD Ryzen AI Max+ 395 ~114 token/sn (LFM2.5); RTX 3090 değeri yok | RTX 3090’da 222 (lfm2.5) ve 216 (gemma4) token/sn |
Bu tabloda iki nokta öne çıkıyor. Birincisi, Liquid’in kendi tablosunda LFM2.5, SWE-Bench Verified’da ve araç/ajan ölçütlerinde Gemma’nın önünde görünüyor; bizim ajan sonucumuz bunun tersi. İkincisi, o tablo bağımsız değil: Liquid hem kendi modelini hem rakibini kendi altyapısında çalıştırmış. Gemma’nın GPQA değeri bile Google’ın yayımladığı 82,3’ün altında; protokol farkı olabilir, ama doğrulayamadık.
Farkın nedenini bilmiyoruz. Olası açıklamalar şunlar; hepsi hipotez, hiçbirini sınamadık.
- Harness farkı: Liquid’in SWE-Bench koşusu OpenCode adlı bir ajan altyapısı kullanıyor; bizim 5 araçlı kendi düzeneğimizden farklı. Araç sunumu ve istem biçimi modelin başarısını değiştirebilir.
- Örnekleme ayarı: Liquid’in önerdiği sıcaklık 0,1, Google’ın Gemma için önerdiği 1,0; biz iki modelde de 0,3 kullandık. Bu ayar iki modelden birini diğerinden daha çok etkilemiş olabilir.
- Paket farkı: Biz topluluk tarafından yüklenmiş bir lfm2.5 paketi kullandık; resmi paketle karşılaştırmadık.
- Görev türü: SWE-Bench gerçek açık kaynak projelerindeki hataları çözer; bizim görevlerimiz yeni yazılmış, modelin eğitim verisinde bulunma ihtimali düşük gizli testlerdi.
Bağımsız ölçümlerde de eksik var. Artificial Analysis’te Gemma 4 26B için sayfa var, LFM2.5 için bulamadık. Atomic Chat’in RTX 5090’da LFM2.5’in terminal görevlerini kazandığını söyleyen bir paylaşımı da var, ama sayfayı açamadık ve yöntemini bilmiyoruz; bu yüzden değerlendirmeye almadık. RTX 3090’da yayımlanmış bir token/sn ölçümü de bulamadık: hesap makinesi siteleri tahmin veriyor ve bizim ölçtüğümüz yazma hızının çok altında değerler gösteriyor; bunları ölçüm saymadık.
Yöntem notu ve sınırlar
#Bu sınırlar sonucun yönünü değiştirmiyor ama büyüklüğünü okurken dikkat etmeyi gerektiriyor. Kendi işinizde sıralama farklı çıkabilir; bu yüzden bir sonraki bölümde işletmeler için ne yapılması gerektiğini ayrı yazıyoruz.
İşletmeniz için ne anlama geliyor?
#Yerel yapay zekâ kurarken model seçimi, ekran kartı seçimi kadar önemli. Aynı donanımda iki model arasında kod testlerinde %83,2’ye karşı %46,8 gibi bir fark çıktı. Bu farkı donanım değil, modelin düşünme davranışı belirledi. Üretici tablolarındaki sıralama, kendi işinizdeki sıralamayla örtüşmeyebilir; bizim testimizde ajan görevinde örtüşmedi.
Kendi işiniz için üç şey öneriyoruz. Birincisi, modeli kendi görevleriniz ve kendi gizli testlerinizle sınayın; genel kıyaslamalara tek başına güvenmeyin. İkincisi, düşünme bütçesini ve modelin bütçeyi bitirdiğinde ne yaptığını ölçün; boş cevap, doğru bir “bilmiyorum”dan daha pahalıdır. Üçüncüsü, model davranışını dar bir pilotta izleyin: aynı görevi birkaç kez çalıştırıp dalgalanmaya bakın.
- Model, görevlerimizin kaçında düşünme bütçesini bitiriyor?
- Cevap yazdığında kod derleniyor ve testleri geçiyor mu?
- Aynı görevi birkaç kez çalıştırdığımızda sonuç ne kadar değişiyor?
- Donanımımızda bellek payı uzun metin ve ikinci bir iş için yetiyor mu?
Verinizin kurum dışına çıkmasını istemiyorsanız, yerel yapay zekâ kurulumu modelin, belge erişiminin ve yetkilerin birlikte planlanmasını gerektirir. Hangi işlerde yapay zekânın değer katacağını belirlemek için yapay zekâ danışmanlığı kullanım alanlarının ve uygun model ve araçların belirlenmesini kapsar. Modelin işini bir yazılıma bağlayacaksanız, özel yazılım geliştirme tarafında da sınama ve entegrasyon planı gerekir.
Bu yazıdaki rakamlar bizim testimize aittir. Başka bir iş, başka bir donanım veya Türkçe talimatlarla sonuç değişebilir; kendi işinizde ölçmeden kararı vermeyin.
Kaynaklar
#- LFM2.5-24B-A2B model kartı — Hugging Face (Liquid AI)huggingface.co
- LFM2.5-24B-A2B duyurusu — Liquid AIliquid.ai
- lfm2.5:24b — Ollamaollama.com
- Gemma 4 model kartı — Google AIai.google.dev
- gemma-4-26B-A4B-it — Hugging Face (Google)huggingface.co
- gemma4 — Ollamaollama.com
- Artificial Analysis — Gemma 4 26B A4Bartificialanalysis.ai
- s1: Simple test-time scaling (budget forcing) — arXiv 2501.19393arxiv.org
- Reasoning Models Can Be Effective Without Thinking — arXiv 2504.09858arxiv.org
- When More Thinking Hurts: Overthinking in LLM Test-Time Compute Scaling — arXiv 2604.10739alphaxiv.org
- Does Thinking More always Help? — arXiv 2506.04210arxiv.org
- Thinking Past the Answer — arXiv 2606.02835arxiv.org
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahip bir dijital pazarlama yöneticisidir. SEO, Generative Engine Optimization (GEO), Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek markaların arama motorları ve yapay zekâ destekli platformlardaki dijital görünürlüğüne yönelik stratejiler geliştirir. Metot Bilişim bünyesinde teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir. Yayınladığı içerikleri güncel teknolojiler, ölçülebilir veriler ve uygulama deneyimi doğrultusunda hazırlar.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinRTX 3090'da hangi yerel model kod için daha iyi?
Testimizde gemma4:26b daha iyi çıktı. Altı kod görevinde toplam 220 gizli testin ortalama %83,2'sini geçti; lfm2.5-24b-a2b %46,8'de kaldı. gemma4 C# ve JavaScript görevlerinde neredeyse kusursuzdu. lfm2.5 yalnızca Roma rakamları gibi kısa, iyi tanımlı bir görevde tam puan aldı.
LFM2.5 neden düşünme bütçesini bitiriyor?
LFM2.5 model kartına göre her zaman önce düşünüyor ve düşünmesi kapanmıyor. C# hesap makinesi görevinde 98 bin karakterlik bir iç ses üretti, sıfır satır kod yazdı ve aynı test senaryosunu defalarca baştan hesapladı. Bütçeyi iki katına çıkarınca cevap yazdı, ama denemelerin yarısında kod derlenmedi; sorun yalnızca süre değil, kod kalitesiydi.
Gemma 4 26B ile LFM2.5 24B hangisi daha az ekran kartı belleği kullanır?
lfm2.5-24b-a2b daha az kullanır. Dosyası 14 GB; testlerde en yüksek bellek kullanımı 16,0 ile 18,2 GB arasındaydı. gemma4:26b dosyası 18 GB; en yüksek kullanım 20,2 ile 22,9 GB arasındaydı. İki model de 24 GB'lık RTX 3090'da tamamen ekran kartında çalıştı, işlemciye taşma olmadı.
Yerel bir model 200 sayfalık bir arşivden soru cevaplayabilir mi?
Testimizde güvenilir biçimde cevaplayamadı. Yaklaşık 80 bin token'lık arşivde (yaklaşık 200 sayfa) düşünme bütçesi bitince gemma4 iki denemede de cevapsız kaldı; lfm2.5 yalnızca 1,2 ve 1,0 puan aldı. Düşünme kapalıyken gemma4 10 sorudan 4,2 puan aldı. Hesap gerektirmeyen bilgi bulma işlerinde iyi, birkaç parçayı birleştirip sayma gerektiren sorularda zayıf kaldı.
Düşünme bütçesi nedir ve ne kadar olmalı?
Düşünme bütçesi, modelin cevap yazmadan önce iç sesine harcayabileceği token sınırıdır. Biz kod ve proje görevlerinde 24.576, uzun doküman görevinde 32 bin token kullandık. Bütçe bitince model cevap veremez. gemma4'te çok zor görevlerde bütçeyi 32–48 bin token'a çıkarmak işe yaradı; lfm2.5'te bütçeyi iki katına çıkarmak sorunu çözmedi.
24 GB VRAM yeterli mi, RTX 3090'da hangi yerel yapay zekâ modelleri çalışır?
Testimizde yeterli oldu. 24 GB'lık RTX 3090'da 14 GB'lık lfm2.5-24b-a2b ve 18 GB'lık gemma4:26b işlemciye taşma olmadan tamamen ekran kartında çalıştı. En yüksek bellek kullanımı yaklaşık 80 bin token'lık uzun dokümanda görüldü: lfm2.5'te 18,2 GB, gemma4'te 22,9 GB. Dosya boyutu tek başına yeterli ölçüt değil; bağlam uzadıkça bellek payı daralıyor.
Yerel bir yapay zekâ modelinin kod yazma başarısı nasıl ölçülür?
Modelin hiç görmediği otomatik testlerle ölçülür; çıktının güzel görünmesi yetmez. Biz modele yalnızca görev metnini ve arayüzü verdik, yazdığı kodu test projesine koyup gizli testleri çalıştırdık ve geçen testlerin oranını puan saydık. Süreyi Ollama'nın zaman sayaçlarıyla, belleği nvidia-smi ile ölçtük. Tekil sonuçlar dalgalanabildiği için her görevi 2–3 kez çalıştırdık.
Gemma 4 26B ve LFM2.5 hangi lisansla yayımlanıyor?
Model kartlarına göre Gemma 4 26B-A4B Apache 2.0, LFM2.5-24B-A2B ise LFM Open License v1.0 lisansıyla yayımlanıyor. İki lisansın koşulları farklı. Ticari kullanımdan önce ilgili lisans metnini okumanız gerekir; bu yanıt hukuki tavsiye değildir.
Yerel yapay zekâ modeli mi, bulut yapay zekâ asistanı mı tercih edilmeli?
Verinin kurum dışına çıkmaması öncelikse yerel model mantıklı olabilir. Bulut asistanlarında yazdığınız metin üreticinin sunucusuna gider; yerel modelde veri makineden çıkmaz ve ücret yerine elektrik harcarsınız. Ama testimizde yerel modeller zor işte dalgalandı: kod testlerinde gemma4 %83,2, lfm2.5 %46,8 aldı. Bulut modelleriyle karşılaştırma yapmadık.
MoE (uzmanlar karışımı) modeli neden hızlı çalışır?
MoE model her token için ağın tamamını değil yalnızca birkaç uzman alt ağını çalıştırır; bu yüzden toplam boyutuna göre az iş yapar. Testimizde lfm2.5 64 uzmandan 4'ünü, gemma4 128 uzmandan 8'ini kullandı ve ikisi de RTX 3090'da saniyede 200'ün üzerinde token yazdı (222 ve 216). Model yine de bütünüyle belleğe yüklenir ve hız tek başına başarıyı göstermez: süre ağırlıklı olarak düşünmeye gitti.
Yapay zekâ ajanı bir yazılım projesini tek başına bitirebilir mi?
Testimizde kısmen bitirebildi. 7 dosyalık bir sipariş yazılımında dört hatayı düzeltip yeni bir özellik eklemesini istedik; 35 gizli kabul testinde gemma4:26b %95, lfm2.5-24b-a2b %49 aldı. gemma4 üç denemeyi de 24–33 adımda tamamladı; lfm2.5 ikisinde 60 adım sınırına takıldı. Tek proje ve tek donanımda yapılmış bir testtir, genelleme yapmayın.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen yerel yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
- yazılım
Özel Yazılım ve Web Uygulaması Geliştirme
Web uygulaması, özel işlev ve entegrasyon ihtiyaçlarınızı birlikte değerlendirelim.
blogdan
İlgili yazılar
- web tasarım
10 dk okuma
Gemma 4 ile Hukuk Bürosu Testi: Sonuçlar
Yerel çalışan gemma4:26b'yi tek RTX 3090'da altı hukuk bürosu görevinde denedik. Düşünme kapalıyken 16 olaylık kronolojide, 12 soruluk kaynaklı aramada, 30 evraklık sınıflandırmada, 40 kişisel verilik maskelemede ve 5 taranmış evrakta hata çıkmadı; sözleşme karşılaştırmada 10 değişikliğin 9'u bulundu. Uydurma tarih, uydurma alıntı ve sızan kişisel veri sıfırdı. Düşünme açıkken 18 çağrının 7'si cevapsız bitti. Belgeler kurgusal, model özelleştirilmemişti; Metot Bilişim'in ince ayar ve RAG uyarlamalarının bu zayıflıklara nasıl denk geldiği ayrı bir bölümde anlatılıyor.
- web tasarım
12 dk okuma
Web Sitesi Tasarımı Hangi Programla Yapılır?
Web sitesi hazırlarken arayüz tasarımı için Figma, kod yazmak için Visual Studio Code, içerik yönetimi için WordPress ve görsel site kurmak için Wix veya Webflow gibi araçlar kullanılabilir. Bunlar farklı görevleri karşılar; seçim sitenin işlevlerine, içerik yönetimine ve bütçesine bağlıdır.
- web tasarım
8 dk okuma
Ankara Web Tasarım Hizmeti: Nasıl Seçilir?
Ankara'da web tasarım hizmeti seçerken önce web sitenizin amacını ve hedef kitlenizi netleştirin. Ardından firmaların önceki çalışmalarını, hizmet kapsamını, müşteri iletişimini ve teklif sürecini karşılaştırın. Kapsam belli olduğunda, projenize özel bir teklif almak en sağlıklı başlangıçtır.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.