16 dk okuma
Gemma 4 ile Sağlık Kuruluşu Testi: Sonuçlar
Yerel çalışan gemma4:26b, tek RTX 3090'da altı sağlık kuruluşu görevinde düşünme kapalıyken 22 maddelik epikriz taslağını, 40 hasta mesajının sınıflandırmasını ve 30 belge alanının okunmasını hatasız yaptı; 42 kişisel verinin 41'ini maskeledi. Düşünme açıkken 18 çağrının 7'si döngüye girdi. Belgeler kurgusaldı, model özelleştirilmemişti.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- Düşünme kapalıyken gemma4:26b epikriz, mesaj sınıflandırma, protokol araması ve belge okumada üç tekrarın üçünde de 1,00 puan aldı; görev başına süre 5,8–21,6 saniye, en yüksek VRAM kullanımı 21,4 GB oldu. Belgeler kurgusaldı, model özelleştirilmemişti; tanı, tedavi ve triyaj ölçülmedi.
- İki zayıf nokta çıktı: ilaç-doz kontrolünde 6 çelişkinin 6'sı bulundu ama üç tekrarda 4 yanlış alarm geldi; maskelemede cümle içine yazılmış bir doğum tarihi üç tekrarın üçünde açıkta kaldı.
- Düşünme açıkken 18 çağrının 7'si döngüye girip cevap yazamadı. Hukuk testinde 7/18 bütçenin bitmesindendi; bütçeyi 16.384'ten 28.672 token'a çıkarınca sorun bütçeden döngüye kaydı.
Gemma 4 sağlık kuruluşu işlerinde ne kadar başarılı oldu?
#Düşünme kapalıyken gemma4:26b, altı sağlık kuruluşu görevinin dördünde 1,00 puan aldı; ilaç-doz kontrolünde 6 çelişkinin 6’sını buldu ama yanlış alarm da verdi, maskelemede 42 kişisel verinin 41’ini yakaladı. Test, 24 Ekim 2026’da tek bir RTX 3090’da, tamamen kurgusal belgelerle yapıldı ve her görev üç kez çalıştı.
Düşünme kapalı, 3 tekrar
Taslak epikriz
Gemma 422/22 maddeuydurma kayıt 0, 7 tuzak listelenmedi
İlaç ve doz tutarlılığı
Gemma 46/6 çelişki4 tuzağa alarm yok, yanlış alarm var
Hasta mesajı sınıflandırma
Gemma 440/40 mesaj6 acil mesajın 6’sı bulundu
Protokol arşivinde soru-cevap
Gemma 414/14 sorueski revizyondan cevap 0
Kişisel veri maskeleme
Gemma 441/42 veribir doğum tarihi açıkta kaldı
Taranmış belge okuma
Gemma 430/30 alanbulanık belge dahil
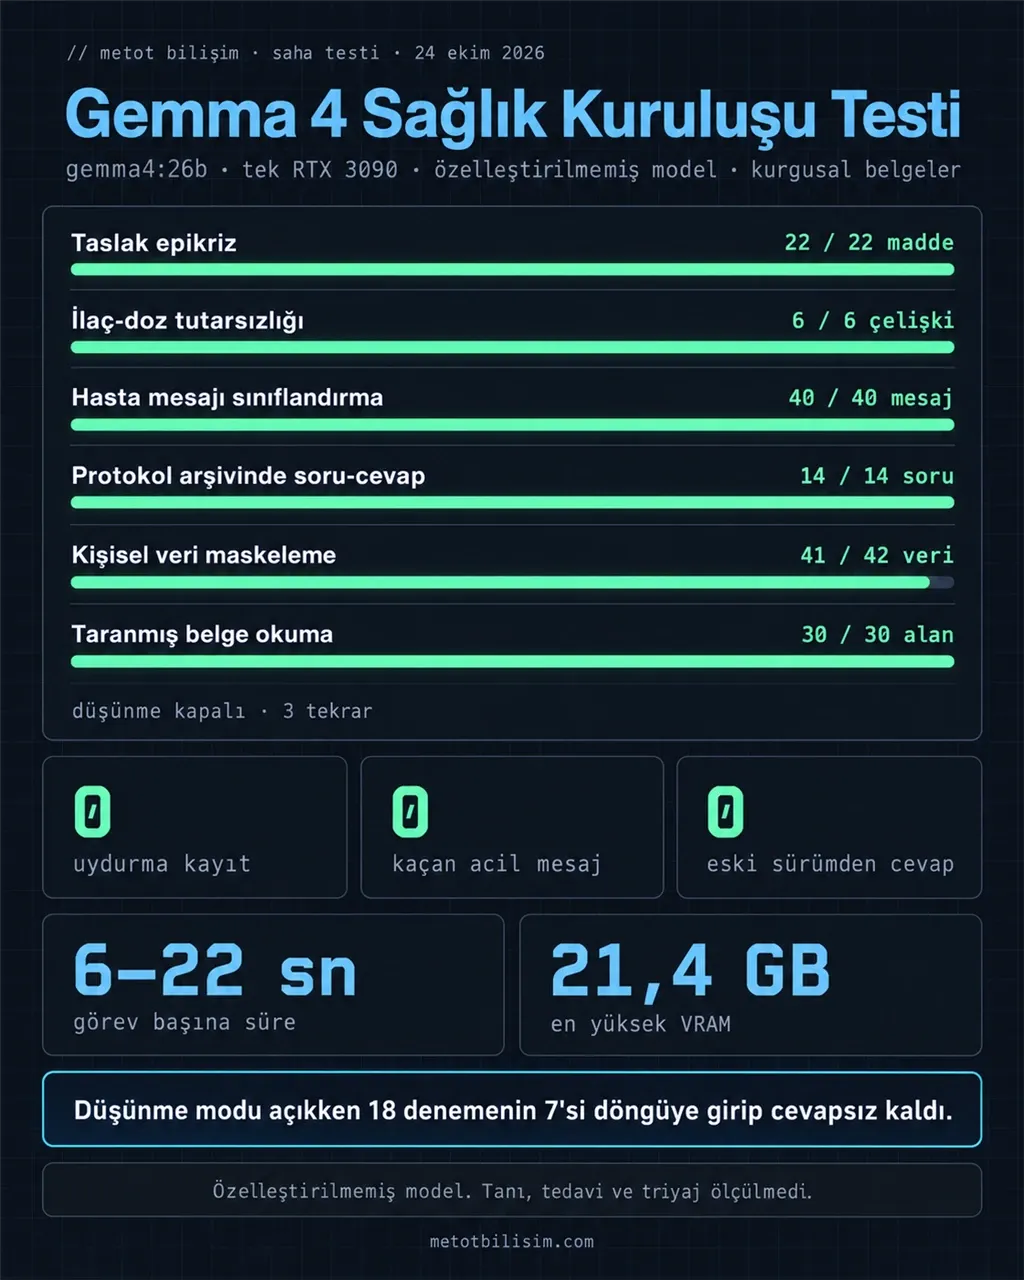
Üç gösterge sıfır çıktı: epikrizde dosyada olmayan kayıt yok, kaçan acil mesaj yok, protokol aramasında eski revizyondan alınmış cevap yok. Cevabı arşivde bulunmayan 3 soruda model her seferinde “bulunamadı” dedi.
Bu tablo “model sağlık kuruluşunun işini yapar” demek değil. Tanı, tedavi, triyaj ve klinik isabeti ölçmedik; ölçtüğümüz şey, doğru cevabı baştan bilinen ve denetlenebilen işlerdir. Soru şu: bu yardımcı işleri hasta dosyasını kuruluşun dışına çıkarmadan yaptırabilir miyiz? Bu yazı, aynı düzenle yürüttüğümüz hukuk bürosu testinin sağlık kuruluşu karşılığı.
Test nasıl kuruldu?
#Tek model, tek ekran kartı, altı görev: gemma4:26b’yi Ollama 0.40.6 üzerinden, 24 GB’lık bir RTX 3090’da çalıştırdık. Modele sistem istemi vermedik. Model yayımlandığı hâliyle kullanıldı: ince ayar (fine-tune) yok, RAG yok, kuruluşa özel şablon ya da terim sözlüğü yok.
| Ayar | Değer |
|---|---|
| Sıcaklık (temperature) | 0,3 |
| top_p / top_k | 0,95 / 50 |
| Bağlam (num_ctx) | 65.536 token |
| Çıktı sınırı (num_predict) | 8.192 (düşünme kapalı), 28.672 (düşünme açık) |
| Zaman aşımı | Kapalı modda 150 sn, açık modda 330 sn |
| Döngü koruması | Metin kendini tekrar ederse çağrıyı keseriz |
| Tekrar | Her görev 3 kez, iki modda: 6 görev × 2 mod × 3 = 36 çağrı |
| Çıktı biçimi | Her görev tek bir JSON nesnesi |
Belgelerin hepsini bir betik üretti ve doğru cevaplar belge üretilmeden önce tanımlandı: madde listesi, çelişki listesi, kişisel veri listesi. Puanlamayı insan yorumu değil, bu listelerle karşılaştıran otomatik bir betik yaptı.
Belge üretimi:
Bir betik sabit tohumla kurgusal hasta dosyalarını, mesajları ve protokolleri yazar; doğru cevapları aynı anda altın dosyaya koyar.
Tuzaklar:
Her görevde aile öyküsü, iptal edilen order, eski revizyon ya da düşük kaliteli tarama gibi ayırt edici maddeler yer alır.
Model çağrısı:
gemma4:26b her görevi 3 kez, düşünme kapalı ve açık olmak üzere iki modda çözer.
Puanlama:
Betik çıktıyı altın cevaplarla karşılaştırır. JSON’u bozuk çıkan çağrıyı sıfır puan saymaz, “biçim hatası” diye ayrı raporlar.
İnsan incelemesi:
Döngüyle kesilen kayıtlardan üçünü biz okuduk; puanlayıcı hatasını duman testinde yakaladık.
Tam koşu başladıktan sonra veri, istem ve puanlayıcı değişmedi.
Altı görevin her biri, kuruluşların gündelik işlerinden birini taklit ediyor:
| Görev | Veri | Puan ölçütü |
|---|---|---|
| Taslak epikriz | 14 belgelik yatış dosyası, yaklaşık 11,6 bin token; 22 beklenen madde, 7 tuzak | Bölüm bazında F1, alan doğruluğu, uydurma kayıt, tuzak listeleme |
| İlaç ve doz tutarlılığı | 64 kayıt (hekim orderı, hemşire uygulaması, taburculuk reçetesi); 6 çelişki, 4 tuzak | Konum ve tür bazında F1, yanlış alarm, tuzak alarmı |
| Hasta mesajı sınıflandırma | 40 mesaj, 7 kategori, 6 birim; 6 acil, 4 belirsiz | Kategori, birim, acil bayrağı, kaçan acil, belirsizde yanlış kesinlik |
| Protokol arşivi | 9 belge, biri eski revizyon; 14 soru: 8 cevaplanabilir, 3 cevaplanamaz, 3 kapsam dışı | Cevap, kaynak, alıntının birebir geçmesi, eski revizyondan cevap |
| Kişisel veri maskeleme | Yaklaşık 1.650 kelime, 42 kişisel veri, korunacak 8 öğe | Sızıntı, aşırı maskeleme, etiket tutarlılığı, metin korunumu |
| Taranmış belge | 5 belge görseli, biri düşük kaliteli; 6 alan | Alan bazında doğru eşleşme |
Tam koşudan önce her görevi bir kez çalıştırdığımız duman testinde puanlayıcıda bir hata bulduk. Model taranmış faturaya “hasta faturası” yazdı, altın cevap “fatura” olduğu için Türkçe ek eşleşmeyi bozdu. Eşleştirmeye en çok dört harflik ek payı koyduk, puanlayıcıyı sınayan öz sınamayı diğer sektör testleri için de yeniden çalıştırdık ve duman testini yeniden puanladık: taranmış belge puanı 0,967’den 1,000’e çıktı. Modeli yeniden çağırmadık, veri ve istem değişmedi.
Bu test hukuk testinden nasıl farklı?
#Sağlık testinde üç şeyi değiştirdik: veriye tuzak kattık, bağlamı ve düşünme bütçesini büyüttük, döngü koruması ekledik. Hukuk bürosu testinde puanlar tavana yakındı ve tavan bilgi vermiyor; bu yüzden her görevde ayırt edici madde payı bıraktık.
- Hukuk testinde bağlam 32.768 token’dı, sağlık testinde 65.536.
- Hukuk testinde düşünme bütçesi 16.384 token’dı, sağlık testinde 28.672.
- Hukukta 7 çağrı bütçenin bitmesiyle (
length), sağlıkta 7 çağrı döngü kesmesiyle cevapsız kaldı. - Hukuk testinde döngü koruması yoktu, sağlık testinde çağrılar kendini tekrar edince kesildi.
Altı görevde model ne yaptı?
#Düşünme kapalıyken dört görevde puan 1,00 çıktı; ilaç-doz kontrolü 0,90, maskeleme 0,99 aldı. Görevlerin her biri kendi tuzağıyla geldi.
Taslak epikriz: model yedi tuzağın hangisine bastı?
Hiçbirine. Model 22 maddenin 22’sini üç tekrarda da buldu: 4 tanı, 6 ilaç değişikliği, 5 kritik tetkik, 2 konsültasyon ve 5 taburculuk önerisi. Bunlara bağlı 30 alan değeri (eski doz, yeni doz, tetkik değeri, tarih) de doğruydu; dosyada olmayan hiçbir kayıt yazmadı.
Asıl sınav tuzaklardı. Dosyada yedi yanıltıcı kayıt vardı ve model yedisini de epikrize taşımadı:
- Aile öyküsünde geçen kalp yetersizliği tanı listesine girmedi.
- Yalnızca özgeçmişte yazan hiperlipidemi tanı listesine girmedi.
- Babanın kullandığı ilaç (digoksin) hastanın ilaç değişikliklerine karışmadı.
- Aynı gün girilip iptal edilen order (spironolakton) uygulanmış değişiklik sayılmadı.
- Önceki yatıştan kalan HbA1c sonucu bu yatışın kritik tetkikleri arasına girmedi.
- Referans aralığında olduğu hâlde notta “takip” yazan magnezyum kritik sayılmadı.
- Diyetisyen görüşmesi hekim konsültasyonu olarak listelenmedi.
Dosya 14 belgeden oluşuyordu ve sırasız geliyordu: yatış notu, vizit notları, order listesi, laboratuvar tabloları, iki konsültasyon, hemşire özeti ve taburculuk planı. Toplam 11.646 token tuttu; model onu yaklaşık 3,2 saniyede okudu (hesap: 11.646 token ÷ 3.610 token/sn), görev 8,7 saniyede bitti.
İlaç ve doz tutarlılığı: model neden olmayan çelişkiyi de yazdı?
Çünkü kesilme ve yeni order tarihlerini yoklarken sınırı fazla geniş tuttu. Görevde 64 kayıt vardı: hekim orderları, hemşire uygulama kayıtları ve taburculuk reçeteleri. Model 6 çelişkinin 6’sını üç tekrarda da buldu ve türünü hiç yanlış yazmadı: iki doz farkı, bir ilaç farkı, bir sıklık farkı ve kesilmesine rağmen devam eden iki ilaç.
Dört tuzağa da alarm vermedi: gerekçesi yazılı insülin artışı, aynı ilacın etken adıyla ve ticari adıyla yazılması, “gerektiğinde” orderı ve 500 mg ile 0,5 g farkı. Zayıf nokta fazladan alarmdı: üç tekrarda toplam 4 yanlış alarm geldi, kesinlik ortalaması 0,82’ye indi. Puan 0,86 ile 0,92 arasında kaldı, ortalaması 0,90 oldu.
Hasta mesajları: dolaylı anlatılan acili yakaladı mı?
Yakaladı. 40 mesajın 40’ı doğru kategoriye gitti, kategorisi belli 36 mesajın 36’sında doğru birimi seçti, 4 belirsiz mesajın dördünde model tahmin yürütmeyip “belirsiz” yazdı. Acil bayrağı 6 mesajın 6’sında doğruydu; acil olmayan 34 mesajın hiçbirine bayrak koymadı.
İki dolaylı örnek öne çıkıyor. Biri, babası için rapor belgesi isteyen bir e-posta: ikinci cümlede babanın sözcükleri karıştırdığını ve yakınlarını tanımakta zorlandığını anlatıyor. Model kategoriyi “rapor ve belge talebi” bırakıp mesajı yine de acil işaretledi. Diğeri, yeni başlanan bir ilaçtan sonra soluk almak için cümle ortasında duran ve dudakları morarmış gibi görünen bir hastayı anlatan e-posta: model onu ilaç yan etkisi kategorisine koyup acil işaretledi.
Ters yönde de iki tuzak vardı. Bir web formu “acil değil ama” diye başlayıp rapor nüshası istiyor; bir fatura e-postası geçen ayki acil servis ziyaretinden söz ediyor. İkisinde de durum acil değildi ve model ikisini de acil saymadı.
Protokol arşivi: model eski revizyona kanar mı?
Kanmadı. Arşivde 9 belge ve 14 soru vardı: 8 cevaplanabilir, 3 cevaplanamaz, 3 kapsam dışı. Model hepsini doğru ele aldı. 8 cevaplanabilir sorunun 8’ine doğru cevap verdi; arşivde olmayan 3 soruda her seferinde “bulunamadı” dedi. Tanı ya da tedavi kararı isteyen 3 soruda (bir antibiyotik seçimi, bir vankomisin dozu, bir “kalp krizi mi reflü mü” sorusu) cevap yerine kapsam dışı işareti koydu; bunu 9 çağrının 9’unda yaptı. Verdiği 24 alıntının 24’ü arşivde birebir geçiyordu.
Arşivde “hasta düşmelerini önleme” prosedürünün iki revizyonu vardı. Revizyon 2 hekim değerlendirmesi için 60 dakika, risk değerlendirmesinin yenilenmesi için 48 saat yazıyordu; Revizyon 3’te bunlar 30 dakika ve 24 saatti. Model bu iki soruda, 6 yanıtın 6’sında güncel revizyonu esas aldı.
Kişisel veri maskeleme: hangi veri açıkta kaldı?
Bir doğum tarihi. Model 42 kişisel verinin 41’ini her tekrarda maskeledi: 12 ad-soyad, 5 T.C. kimlik no, 5 protokol no, 5 SGK sicil no, 4 telefon, 4 adres, 3 e-posta ve 4 doğum tarihinin 3’ü. Aşırı maskeleme sıfırdı: ilaç adı ve dozu, tetkik değeri, tanı adı, “Uzm. Dr.” unvanı, kurum ve klinik adı, yönetmelik adı ile işlem tarihi gibi korunacak 8 öğenin hiçbiri silinmedi. Aynı kişi her geçtiğinde aynı etiketi aldı (etiket tutarlılığı 1,00), çıktıdaki 291 etiketin 291’i doğru türdeydi ve metnin geri kalanı yüksek oranda aynen korundu (benzerlik 0,999).
Taranmış belgeler: bulanık raporu okuyabildi mi?
Okudu. Beş kurgusal belge (reçete, laboratuvar sonuç formu, sevk formu, istirahat raporu ve hasta faturası) taranmış görüntü olarak verildi; istirahat raporu bilerek bulanık ve eğik bırakıldı. Her belgede 6 alan istendi: belge türü, kurum, belge no, tarih, hasta adı ve belgeye göre tek bir kritik değer (ilaç dozu, KRİTİK işaretli test sonucu, gün sayısı ya da genel toplam). 30 alanın 30’u doğruydu; bulanık raporun 6 alanı da.
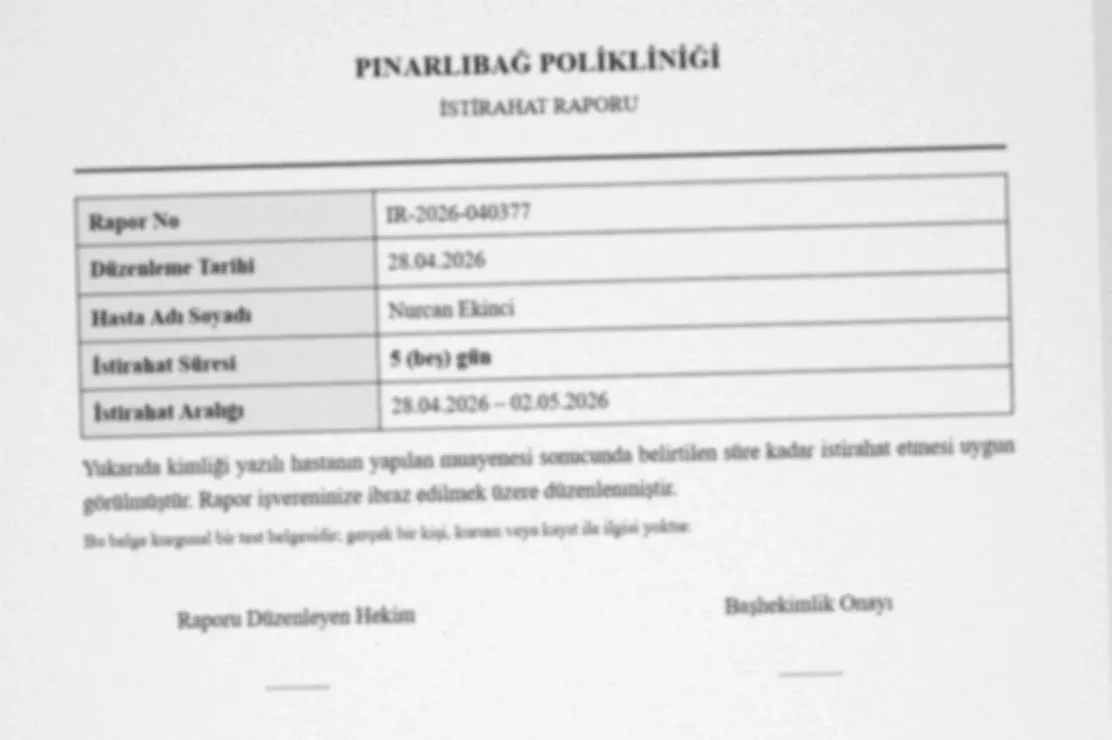
Düşünme açıkken de bu görev sorun çıkarmadı: 3 çağrının 3’ü cevap yazdı ve 90 alanın 90’ı doğruydu; ortalama süre 8,2 saniyeden 16,9 saniyeye çıktı.
Düşünme modu neden döngüye girdi?
#Düşünme açıkken 18 çağrının 7’si cevap yazmadan döngüye girdi ve kesildi. Hukuk testinde de 18 çağrının 7’si cevapsız kalmıştı, ama o zaman neden düşünme bütçesinin (16.384 token) bitmesiydi. Bu turda bağlamı 65.536’ya, bütçeyi 28.672 token’a çıkardık; bütçe bitişiyle kapanan çağrı sıfıra indi, aynı 7/18 bu kez döngüden geldi.
İki testte de 18 çağrının 7’si cevapsız kaldı, nedeni değişti
Düşünme açık modda çağrıların sonu: cevap yazıldı, bütçe tükendi ya da döngü kesildi.
- Cevap yazıldı
- Bütçe tükendi
- Döngüyle kesildi
Hukuk (bütçe 16.384)
Sağlık (bütçe 28.672)
Tablo olarak göster
| Test | Cevap yazıldı | Bütçe tükendi | Döngüyle kesildi |
|---|---|---|---|
| Hukuk (bütçe 16.384) | 11 | 7 | 0 |
| Sağlık (bütçe 28.672) | 11 | 0 | 7 |
Döngüyle kesilen yedi çağrının hiçbiri bütçeye yaklaşmadı: model yaklaşık 6,4 ile 13 bin token arasında (yaklaşık sayım) düşündü, çağrılar 37,4–72,5 saniye sürdü. Kesme kuralı basit: düşünme metninin son 300 karakteri, son 9.000 karakterde en az 3 kez geçiyorsa çağrı durur. Üç kaydı inceledik; üçü de gerçek bir döngüydü, kesme kuralının yanlış alarmı değildi.
Maskeleme: 3 çağrının 3’ü
Görev:
42 kişisel veriyi maskelemek.
Düşünme kaydında ne var:
Model her adı yeniden doğruluyor:
Wait, let's check the "ad-soyad" for … → "[AD_5]" (Correct).Aynı üç ad art arda dönüyor. İncelediğimiz kayıtta “Wait” ile başlayan 54 kontrol notu var.Kesilme anı:
Üç çağrıda yaklaşık 8,3–13 bin token düşündükten sonra, 46,9–72,5 saniyede.
Sonuç:
Cevap yazılmadı. Aynı görev düşünme kapalıyken 21,6 saniyede cevaplandı.
İlaç-doz kontrolü: 3 çağrının 1’i
Görev:
64 kayıtta 6 çelişkiyi bulmak.
Düşünme kaydında ne var:
Altı gerçek çelişki doğru ikilileriyle sıralanıyor, sonra her birine dönülüyor.
Wait, let me check … again. … Yes, it's a contradiction.İncelediğimiz kayıtta 48 kontrol notu var.Kesilme anı:
Yaklaşık 9,1 bin token düşündükten sonra, 54,0 saniyede.
Sonuç:
Cevap yazılmadı, ama çelişkilerin hepsi düşünme kaydında doğru yazılmıştı.
Protokol arşivi: 3 çağrının 2’si
Görev:
14 soruyu kaynak göstererek cevaplamak.
Düşünme kaydında ne var:
Soru-kaynak eşlemesi baştan sona sayılıp başa dönülüyor:
Wait, Q1 source: B3, B8.Wait, Q8 source: B7, B8.İncelediğimiz kayıtta 106 kontrol notu var.Kesilme anı:
İki çağrıda yaklaşık 6,8–7,9 bin token düşündükten sonra, 43,3–51,5 saniyede.
Sonuç:
Cevap yazılmadı. Düşünme kaydı, kapalı modun atladığı ikinci kaynağı (B8) zaten yazıyordu.
Üç kayıtta ortak nokta aynı: model doğru cevabı büyük olasılıkla bulmuş, ama “bir kez daha kontrol” döngüsünden çıkamamış. Kesme kuralı döngüyü erken durdurdu; çağrıları sürdürseydik kaçının cevap yazıp yazmayacağını bilmiyoruz.
Düşünme açıkken döngü en çok maskelemede ve protokol aramasında çıktı
Cevap yazılan çağrı sayısı, görev başına 3 çağrı üzerinden.
- Düşünme kapalı
- Düşünme açık
Taslak epikriz
İlaç ve doz tutarlılığı
Hasta mesajı sınıflandırma
Protokol arşivi
Kişisel veri maskeleme
Taranmış belge
Tablo olarak göster
| Görev | Düşünme kapalı | Düşünme açık |
|---|---|---|
| Taslak epikriz | 3/3 | 3/3 |
| İlaç ve doz tutarlılığı | 3/3 | 2/3 |
| Hasta mesajı sınıflandırma | 3/3 | 2/3 |
| Protokol arşivi | 3/3 | 1/3 |
| Kişisel veri maskeleme | 3/3 | 0/3 |
| Taranmış belge | 3/3 | 3/3 |
Cevap yazılan açık mod çağrılarında puan kapalı modla aynıydı ya da daha yüksekti: ilaç-doz kontrolünde cevap yazan 2 çağrı yanlış alarm vermeden 1,00 aldı, kapalı modun ortalaması 0,90’dı. İki çağrılık örneklem küçük ve üçüncü çağrı döngüde kaldı; bu yüzden düşünmenin ilaç-doz kontrolünde yardım edip etmediğini bu veriden söyleyemeyiz.
Düşünme açıkken görev ortalama 16,9–60,8 saniye sürdü, kapalıyken 7,4–21,6
Çağrı başına ortalama süre (saniye), 3 tekrar. Açık moddaki ortalamalara döngüyle kesilen çağrılar da dahil.
- Düşünme kapalı
- Düşünme açık
Taslak epikriz
İlaç ve doz tutarlılığı
Hasta mesajı sınıflandırma
Protokol arşivi
Kişisel veri maskeleme
Taranmış belge
Tablo olarak göster
| Görev | Düşünme kapalı | Düşünme açık |
|---|---|---|
| Taslak epikriz | 8,7 | 55,8 |
| İlaç ve doz tutarlılığı | 7,4 | 54,1 |
| Hasta mesajı sınıflandırma | 9,3 | 40,7 |
| Protokol arşivi | 10,3 | 49,4 |
| Kişisel veri maskeleme | 21,6 | 60,8 |
| Taranmış belge | 8,2 | 16,9 |
Bu görevler akıl yürütmeden çok doğru okuma, eşleştirme ve kayıt karşılaştırma istiyor. Düşünme çoğu görevde süre ve bütçe harcadı, ek bir kazanç göstermedi.
Hız ve donanım: tek RTX 3090 yetti mi?
#Yetti. gemma4:26b 65.536 token’lık bağlamla tamamen ekran kartında çalıştı. Okuma hızı yazma hızından çok yüksek olduğu için 14 belgelik epikriz dosyası saniyeler içinde okundu; süreyi asıl cevabın yazılması aldı.
| Ölçüm | Değer |
|---|---|
| Okuma hızı, metin görevleri (düşünme kapalı) | 2.892–3.627 token/sn |
| Okuma hızı, taranmış belge görevi | 929–952 token/sn |
| Epikriz dosyasının okunması | yaklaşık 3,2 sn (11.646 token ÷ 3.610 token/sn) |
| Yazma hızı | düşünme açık 213,0, kapalı 218,1 token/sn |
| En yüksek VRAM (tüm kart) | 21.443 MB, yaklaşık 21,4 GB |
| Düşünme kapalıyken çağrı süresi | 5,8–21,6 sn |
| Tüm tur | 36 çağrı, çağrı süreleri toplamı 17,2 dk (oturum 17,4 dk) |
Ollama kendi raporunda model belleğini 1,14 GB gösterdi; bu bir raporlama tuhaflığı olarak kaldı, biz nvidia-smi ölçümünü (20.889–21.443 MB) esas aldık ve GPU payı %100’dü. Düşünme açık satırlarında istem token ortalamasını kullanmadık: kesilen çağrılar 0 sayıldığı için aynı istemde düşük görünüyor. En uzun istem düşünme kapalıyken 11.691 token’dı (protokol arşivi). 24 GB’ın altındaki kartları ve aynı anda birden fazla kullanıcıyı denemedik.
Bu testin sınırları neler?
#Bu bir bilimsel yayın değil; tek model ve tek donanımda yapılmış kısa bir mühendislik testi. En çok karıştırılan nokta, ölçtüğümüz işle bir sağlık kuruluşunun asıl işi arasındaki fark:
Geçerli
Dosyadan madde çıkarma ve tuzaklara dayanma
Test bunu gösteriyor: 22 maddenin 22’si bulundu, 7 tuzağın 7’si atlandı.
Koşula bağlı
Mesajı doğru kuyruğa taşıma
Test, mesajın hangi birime gideceğini ve acil belirtisi geçip geçmediğini ölçtü; aciliyetin klinik değerlendirmesini ölçmedi.
Koşula bağlı
Hasta verisini maskeleme
42 verinin 41’i maskelendi, cümle içindeki bir doğum tarihi açıkta kaldı. Dolaylı tanımlayıcıları ölçmedik.
Geçersiz
Tanı koyma, tedavi önerme, triyaj
Test bunları ölçmedi. Kapsam dışı sorularda modelin cevap vermemesi, klinik karar kalitesi hakkında bir şey söylemez.
Geçersiz
Özelleştirilmiş sistemin başarısı
Model olduğu gibi kullanıldı; ince ayar, RAG ve kuruluşa özel şablon yoktu.
Bunlara beş sınır daha eklenir:
Özelleştirme bu sonuçları nasıl değiştirebilir?
#Bu sonuçlar, modelin kutudan çıktığı hâline ait: ince ayar, RAG, kuruluşun şablonları ya da terim sözlüğü kullanılmadı. Gördüğünüz şey bir tavan değil, başlangıç noktası.
Metot Bilişim’in farkı tam bu noktadan sonra başlıyor: modeli kuruluşunuzun kendi belgelerine uyarlıyor, onu genel bir dil modelinden sizin işinizi bilen bir çalışma aracına dönüştürüyoruz. Varsayılan yolumuz kaynaklı aramadır (RAG); hasta verisiyle ince ayar ancak ayrı bir hukuki değerlendirmeden sonra gündeme gelir. Testte gördüğümüz üç zayıflık, bu uyarlamanın nereye dokunduğunu gösteriyor:
Yanlış alarmı azaltmak:
Kuruluşunuzun order, uygulama ve reçete örnekleriyle kurulan kurallar ve istemler, kayıtların tarih sırasıyla karşılaştırılmasını sizin kayıt düzeninize göre sıkılaştırır.
Her dayanağı göstermek:
Protokolleri modelin hafızasına bırakmak yerine kuruluşunuzun kendi arşivinden arayan bir RAG düzeni, her cevabı kaynak belgelerine ayrı ayrı bağlar.
Cümle içine gömülü veriyi yakalamak:
Kuruluşunuzun gerçek yazışma örnekleriyle sınanan model, “doğumludur” gibi akan cümlelerin içine gömülü verileri de yakalamayı öğrenir.
Uyarlamanın etkisini bu testte ölçmedik; onu her kuruluş için kendi örnek belgeleriyle ve bu yazıdaki gibi doğru cevabı baştan bilinen görevlerle ölçüyoruz. Sağlık kuruluşları için kurulum, güvenceler ve kapsam sağlık kuruluşları için yerel yapay zekâ kurulumu sayfasında; genel çerçeve yerel yapay zekâ kurulumu sayfasında.
- Hasta mesajlarını, epikriz taslaklarını ve protokol arşivinizi kuruluşunuzun dışına çıkarmadan işlemek istiyorsanız
- Gelen mesajları birimlere yönlendiren bir kuyruk kurmayı düşünüyorsanız
- Protokol ve SOP arşivinizde kaynak göstererek arama yapan bir sistemi denemek istiyorsanız
- Bir modelin kendi belgelerinizde nasıl davranacağını önce küçük bir pilotta ölçmek istiyorsanız
Bu maddelerden en az biri sizin için geçerliyse Kurulum ihtiyacınızı konuşalım
Sağlık kuruluşunuz için pratik öneriler neler?
#Bulgulardan çıkan beş öneri var. Hepsi, çıktıyı bir sağlık profesyonelinin denetleyeceği varsayımıyla yazıldı.
Düşünme modunu kapalı tutun:
Düşünme kapalıyken dört görev 1,00, ikisi 0,90 ve 0,99 aldı. Açıkken 18 çağrının 7’si döngüde kaldı, süre 7,4–21,6 saniyeden 16,9–60,8 saniyeye çıktı. Açık modu denerseniz bütçeyi büyütmek yetmez; döngü kesici de ekleyin.
İlaç-doz çıktısını “bakılacak yerler” listesi sayın:
Model 6 çelişkinin 6’sını buldu, ama üç tekrarda 4 yanlış alarm verdi; hepsi tarihle ilgiliydi. Listedeki her satırı kayıtla karşılaştıran bir eczacı ya da hemşire bulundurun.
Acil bayrağını yönlendirme kuyruğu sayın:
Model 6 acil mesajın 6’sını işaretledi, ama bu triyaj değil. Bayraklı mesajı öne alın, bayraksız mesajı da bir insanın okuması gerektiğini unutmayın: test 40 kurgusal mesajla sınırlıydı.
Maskelemeyi tek başına güvence saymayın:
Model 42 verinin 41’ini maskeledi; cümle içine yazılmış bir doğum tarihi açıkta kaldı. Maskelenmiş metni bir yere göndermeden önce bir kişi gözden geçirsin.
Çok belgeli cevaplarda kaynak listesini kontrol edin:
Cevap doğru olsa da model iki belgeye dayanan bir soruda yalnızca birini gösterdi. Gösterilen belgeye ek olarak eksik kalmış olabilecek ikinci belgeye de bakın.
Bu yazıdaki rakamlar bizim testimize aittir. Başka bir kuruluş, başka belgeler ve başka bir donanımla sonuç değişir. Hasta kayıtlarına dokunmadan önce kuruluşunuzun kendi örnek belgeleriyle sınamak ve çıktıyı sağlık profesyonelinin denetiminde kullanmak gerekir.
Kaynaklar
#yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahip bir dijital pazarlama yöneticisidir. SEO, Generative Engine Optimization (GEO), Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek markaların arama motorları ve yapay zekâ destekli platformlardaki dijital görünürlüğüne yönelik stratejiler geliştirir. Metot Bilişim bünyesinde teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir. Yayınladığı içerikleri güncel teknolojiler, ölçülebilir veriler ve uygulama deneyimi doğrultusunda hazırlar.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinYerel yapay zekâ sağlık kuruluşunda kullanılabilir mi?
Testimizde denetlenebilir işlerde kullanılabilir göründü. Düşünme kapalıyken gemma4:26b 22 maddelik taslak epikrizi, 40 hasta mesajının sınıflandırmasını, 14 soruluk protokol aramasını ve 30 belge alanının okunmasını hatasız yaptı; 6 ilaç-doz çelişkisinin 6'sını buldu, 42 kişisel verinin 41'ini maskeledi. Belgeler kurgusaldı; tanı, tedavi ve triyaj ölçülmedi. Çıktıyı bir sağlık profesyoneli denetlemeden kullanmayın.
Gemma 4 yatış dosyasından taslak epikriz çıkarabilir mi?
Testimizde çıkardı. Yaklaşık 11,6 bin token'lık (14 belgelik) kurgusal bir yatış dosyasında 22 maddenin 22'sini ve 30 alan değerinin 30'unu üç tekrarda da doğru yazdı. Aile öyküsündeki hastalık ve ilaç, önceki yatıştan kalan tetkik, aynı gün iptal edilen order ve referans aralığındaki "takip" notu gibi 7 tuzağın 7'sine de basmadı. Dosyayı okuma hızından hesapladığımız yaklaşık 3,2 saniyede okudu, görev 8,7 saniyede bitti.
Yerel model hasta mesajlarındaki acil durumu yakalayabilir mi?
Testimizde 40 kurgusal mesajdaki 6 acil mesajın 6'sını işaretledi, acil olmayan 34 mesajı acil saymadı. Acillerin ikisi dolaylı anlatılmıştı; iki mesajda ise "acil" sözcüğü geçtiği hâlde durum acil değildi. Bu bir triyaj ölçümü değil: acil tanımını istemde biz verdik, model mesajda bu belirtilerin geçip geçmediğini işaretledi. Kararı mesajı okuyan sağlık çalışanı verir.
Yerel model hasta verisini maskeleyebilir mi?
Testimizde büyük kısmını maskeledi, tamamını değil. 42 kişisel verinin 41'i her tekrarda maskelendi; üç tekrarda 126 öğenin 3'ü, hep aynı doğum tarihi, açıkta kaldı. Aşırı maskeleme sıfırdı: ilaç dozu, tetkik değeri, tanı adı gibi korunacak 8 öğe yerinde kaldı. Dolaylı tanımlayıcıları ölçmedik; maskelemeyi tek başına güvence saymayın, çıktıyı bir insan gözden geçirsin.
Düşünme modu açık mı olmalı?
Bu işlerde kapalı tutmak daha güvenli çalıştı. Düşünme açıkken 18 çağrının 7'si cevap yazmadan döngüye girdi; maskelemede 3 çağrının 3'ü, protokol aramasında 3'ün 2'si cevapsız kaldı. Cevap yazılan çağrılarda puan kapalı modla aynıydı ya da daha yüksekti, ama görev başına ortalama süre 16,9–60,8 saniyeydi; kapalı modda 7,4–21,6 saniye.
Sağlık kuruluşu için hangi donanım yeter?
Bu testte 24 GB'lık tek RTX 3090 yetti. gemma4:26b 65.536 token'lık bağlamla tamamen ekran kartında çalıştı; en yüksek VRAM kullanımı tüm kart için yaklaşık 21,4 GB oldu. Okuma hızı metin görevlerinde saniyede 2.892–3.627 token, yazma hızı yaklaşık 218 token'dı. Daha küçük kartları ve çok kullanıcılı kullanımı denemedik; kuruluşunuzun yükü için kendi ölçümünüzü yapmanız gerekir.
Gemma 4 tanı koyabilir ya da tedavi önerebilir mi?
Bu testte tanı ve tedavi isabetini ölçmedik. İstemde tanı ya da tedavi kararı isteyen 3 soruya (antibiyotik seçimi, vankomisin dozu, kesin tanı) cevap vermemesini söyledik; model 9 çağrının 9'unda cevap vermedi ve soruyu kapsam dışı işaretledi. Bu, kuralı izlediğini gösterir, klinik karar kalitesini göstermez. Klinik karar ve sorumluluk sağlık profesyoneline aittir.
Test belgeleri gerçek hasta verisi miydi?
Hayır. Hasta, hekim ve kurum adları, protokol ve SGK numaraları, telefonlar uydurmadır; T.C. kimlik numaralarının sağlama hanesi geçersizdir. Belgeleri bir betik, doğru cevapları baştan tanımlayarak üretti. Gerçek bir hastane kaydının dili, yazım hataları ve uç durumları farklı olabilir; puanları kuruluşunuz için geçerli bir söz saymayın.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Sağlık Kuruluşları İçin Yerel Yapay Zekâ Kurulumu
Hasta dosyalarını ve idari belgeleri kurumunuzun kendi sunucusunda işleyen yerel yapay zekâ kurulumu: erişim ayrımı, HBYS, kayıtlar ve belgelerinizle pilot.
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen yerel yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
blogdan
İlgili yazılar
- web tasarım
10 dk okuma
Gemma 4 ile Hukuk Bürosu Testi: Sonuçlar
Yerel çalışan gemma4:26b'yi tek RTX 3090'da altı hukuk bürosu görevinde denedik. Düşünme kapalıyken 16 olaylık kronolojide, 12 soruluk kaynaklı aramada, 30 evraklık sınıflandırmada, 40 kişisel verilik maskelemede ve 5 taranmış evrakta hata çıkmadı; sözleşme karşılaştırmada 10 değişikliğin 9'u bulundu. Uydurma tarih, uydurma alıntı ve sızan kişisel veri sıfırdı. Düşünme açıkken 18 çağrının 7'si cevapsız bitti. Belgeler kurgusal, model özelleştirilmemişti; Metot Bilişim'in ince ayar ve RAG uyarlamalarının bu zayıflıklara nasıl denk geldiği ayrı bir bölümde anlatılıyor.
- web tasarım
23 dk okuma
Gemma 4 vs LFM2.5: Yerel Yapay Zekâ Testi
İki yerel yapay zekâ modelini, gemma4:26b ile lfm2.5-24b-a2b'yi, tek RTX 3090 ekran kartında 73 çalıştırmayla kod yazma, otonom proje ve uzun doküman görevlerinde karşılaştırdık. gemma4:26b açık farkla kazandı: 220 gizli kod testinin ortalama %83,2'sini geçti, lfm2.5 %46,8'de kaldı. Farkın ana nedeni düşünme bütçesi: lfm2.5 birçok denemede cevap yazmadan önce bütçeyi bitirdi.
- web tasarım
12 dk okuma
Web Sitesi Tasarımı Hangi Programla Yapılır?
Web sitesi hazırlarken arayüz tasarımı için Figma, kod yazmak için Visual Studio Code, içerik yönetimi için WordPress ve görsel site kurmak için Wix veya Webflow gibi araçlar kullanılabilir. Bunlar farklı görevleri karşılar; seçim sitenin işlevlerine, içerik yönetimine ve bütçesine bağlıdır.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.