12 dk okuma
Gemma 4 ve Qwen3.6: Önerilen Ayarlarla Benchmark
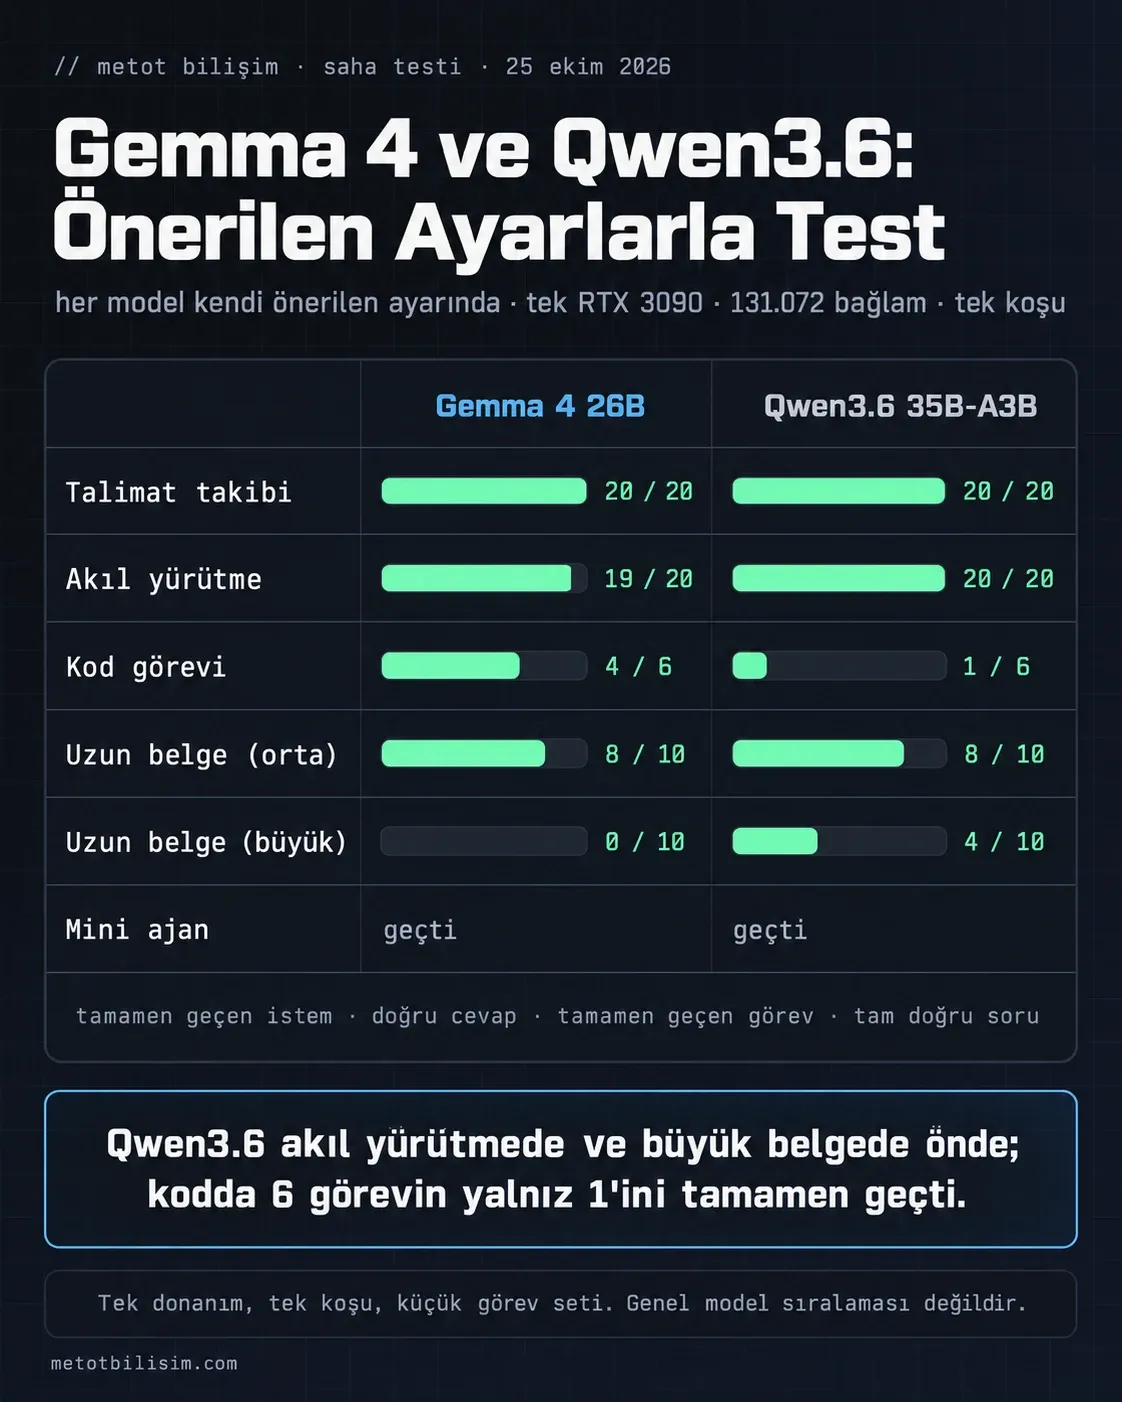
Gemma 4 26B ile Qwen3.6-35B-A3B'yi tek RTX 3090'da, üreticilerinin önerdiği ayarlarla karşılaştırdık. Talimatta eşit sonuç aldılar; akıl yürütmede Qwen, kodda Gemma daha çok görevi geçti. Büyük belgede Gemma cevap yazamadı, Qwen 10 sorudan 4'ünü bildi; küçük projedeki dört hatayı ikisi de düzeltti.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- İki model de 20 talimat istemini eksiksiz geçti; bu sonuç metinlerin içerik doğruluğunu göstermiyor. Akıl yürütmede Qwen 20/20, Gemma 19/20 aldı.
- Kodda Gemma altı görevin dördünü, Qwen birini tamamen geçti. Qwen'in iki C# çözümü derlenmedi; bir JavaScript görevinde tekrara düştü ve kod yazamadı.
- Orta belgede ikisi de 8/10 aldı; büyük belgede Gemma cevapsız kaldı, Qwen 4/10 aldı. Küçük projeyi Qwen 2 dakika 17 saniyede, Gemma 5 dakika 38 saniyede bitirdi.
Gemma 4 ve Qwen3.6 hangi işlerde ayrıştı?
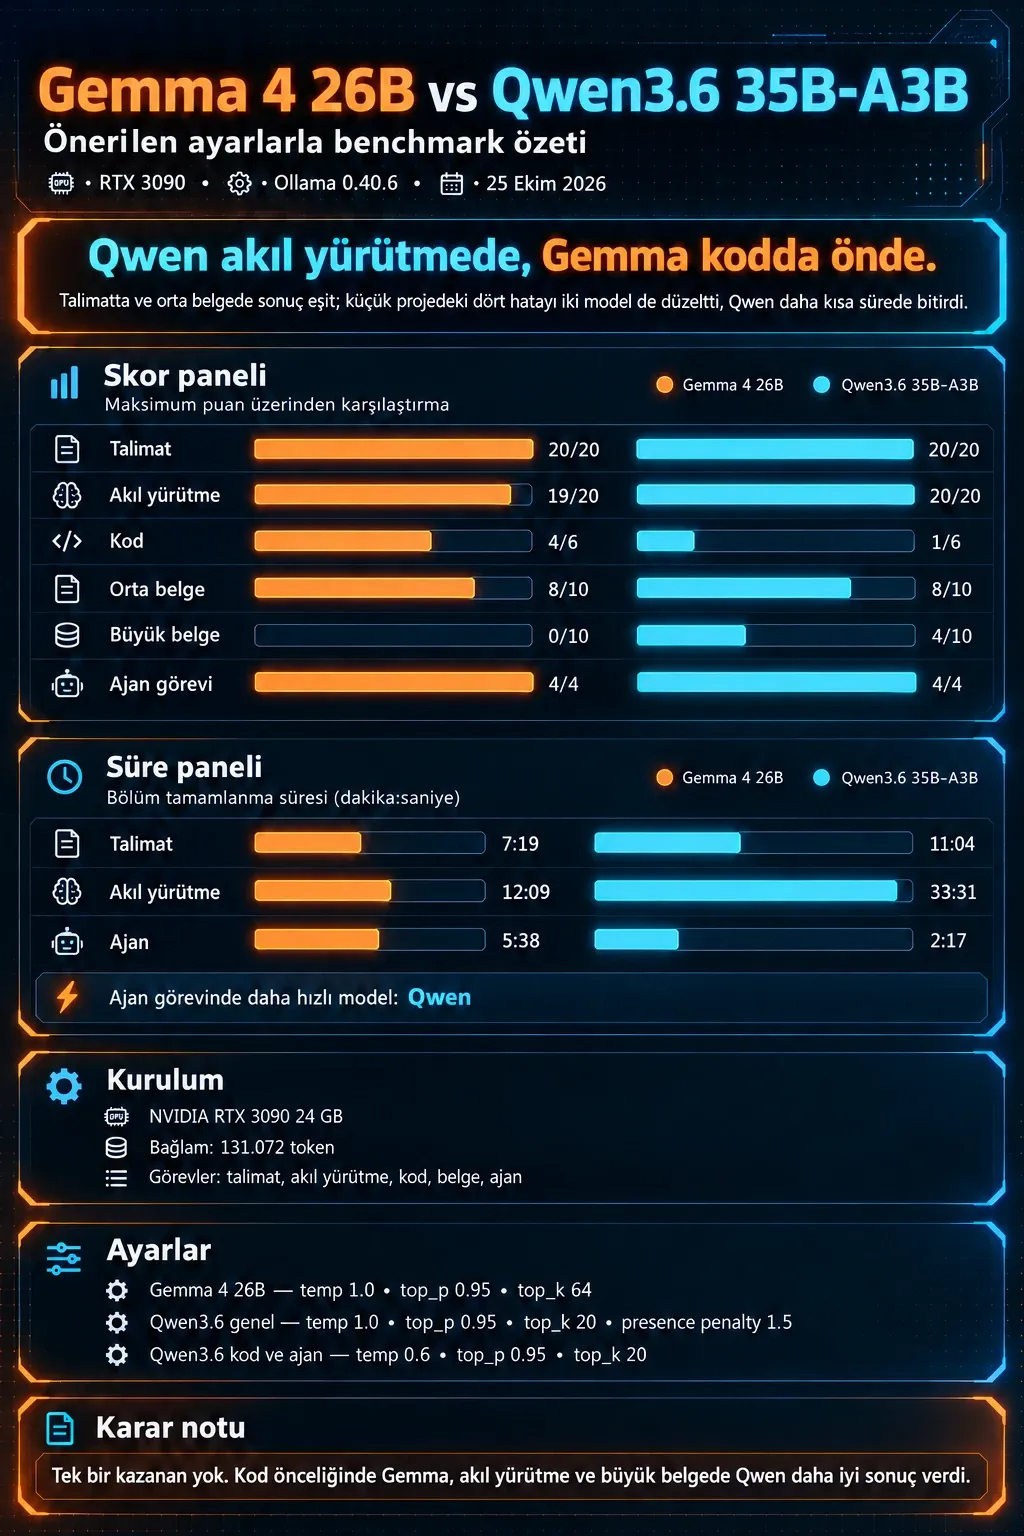
#Qwen akıl yürütmede ve büyük belgede daha çok doğru cevap verdi; Gemma kodda daha çok görevi eksiksiz çözdü. Talimatta ve orta boy belgede sonuçlar eşitti. Küçük bir yazılım projesindeki dört hatayı da ikisi düzeltti; Qwen daha kısa sürede bitirdi.
Karşılaştırma 25 Ekim 2026 tarihli kayıtlara dayanıyor. Gemma 4 26B ile Qwen3.6-35B-A3B’ye aynı görevleri verdik ve her modelde üreticisinin önerdiği ayarları kullandık.
Talimat: eksiksiz geçilen istem
Gemma 4 26B20/20Qwen3.6 35B-A3B20/20Akıl yürütme: doğru cevap
Gemma 4 26B19/20Qwen3.6 35B-A3B20/20Kod: eksiksiz çözülen görev
Gemma 4 26B4/6Qwen3.6 35B-A3B1/6Orta belge: tam doğru cevap
Gemma 4 26B8/10Qwen3.6 35B-A3B8/10Büyük belge: tam doğru cevap
Gemma 4 26B0/10, cevap yokQwen3.6 35B-A3B4/10Küçük proje: düzeltilen hata
Gemma 4 26B4/4Qwen3.6 35B-A3B4/4
İşletme açısından ayrım, modelin hangi işi teslim edebildiğinde yatıyor. Qwen bir bulmacada Gemma’nın kaçırdığı cevabı buldu; buna karşılık altı kod görevinin yalnızca birini eksiksiz çözdü.
Testi hangi makinede ve hangi paketlerle yaptık?
#Testte 24 GB bellekli tek NVIDIA RTX 3090 ve Ollama 0.40.6 kullandık. Ollama, modelleri kendi bilgisayarınızda çalıştırmanızı sağlayan bir programdır.
Gemma’yı bu karşılaştırma için yeniden çalıştırmadık; sonuçlarını aynı günün Gemma–LFM koşusundan aldık. O koşuda aynı makine, aynı Ollama sürümü, aynı görev ve puanlayıcı dosyaları kullanılmıştı. Ayrıntılar Gemma 4 ve LFM2.5: Önerilen Ayarlarla Karşılaştırmalı Benchmark yazısında.
Gemma için gemma4:26b, Qwen için hf.co/unsloth/Qwen3.6-35B-A3B-GGUF:UD-IQ4_XS paketini kullandık. IQ4_XS, modelin sayısal verilerini daha az yer tutacak biçimde sıkıştıran paket türüdür. Qwen paketi resmî Qwen dosyası değil, Unsloth’un sıkıştırılmış GGUF sürümüydü ve Ollama’da 18 GB tutuyordu.
MoE, modelin bütün parametreleri yerine her metin parçasında seçili uzman bölümlerini çalıştıran mimaridir. Qwen’in toplam 35 milyar parametresinin yaklaşık 3 milyarı her parçada çalışıyor; paket bilgisi toplamı 34,7 milyar olarak veriyor. Paketteki görüntü işleme bileşenini kullanmadık.
Token, modelin metni işlerken kullandığı, bir kelimenin tamamı ya da bir kısmı olabilen küçük parçadır. Bağlam penceresi, modelin girdi, düşünme ve cevap için bir seferde kullanabildiği toplam alandır. İki modelde de bu alanı 131.072 token olarak ayarladık.
- Ön kontrolde iki model de tamamen ekran kartında çalıştı; Qwen yaklaşık 20,4 GB yer tuttu.
- Görev başına çıktı, süre veya adım sınırı koymadık; tek uzunluk sınırı 131.072 token bağlamdı.
- Bağlam dolunca eski metni silerek devam etme ve istemi kırpma özelliklerini kapattık.
- İki modelde de cevap öncesi düşünme açıktı; her görevi bir kez çalıştırdık.
Tekrar döngülerine ve yanıtsız kalmaya karşı durdurma kuralları vardı. Son 300 karakter, önceki 30.000 karakter içinde altı kez geçerse çalıştırma duruyordu; istemden alıntılarda eşik 12 tekrardı. Beş dakika boyunca veri gelmemesi de durdurma nedeniydi.
Önerilen ayarların hangilerini kullandık?
#Gemma için Google’ın tek önerisini, Qwen için model kartındaki genel ve kesin kodlama önerilerini kullandık. Sıcaklık, modelin cevap üretirken yaptığı seçimlerin ne kadar değişken olacağını belirleyen ayardır. top_p ve top_k seçenek havuzunu daraltır; min_p düşük olasılıklı seçenekleri eler, ceza ayarları tekrarları etkiler.
| Ayar | Gemma 4 | Qwen: genel | Qwen: kesin kodlama |
|---|---|---|---|
| Sıcaklık | 1,0 | 1,0 | 0,6 |
| top_p | 0,95 | 0,95 | 0,95 |
| top_k | 64 | 20 | 20 |
| min_p | kartta yok | 0 | 0 |
| presence_penalty | kartta yok | 1,5 | 0 |
| repetition_penalty | kartta yok | 1,0 | 1,0 |
Qwen’de kod ve ajan görevlerine kesin kodlama ayarını, talimat, akıl yürütme ve uzun belgeye genel ayarı uyguladık. Ajan, dosya okuma, düzenleme ve test çalıştırma gibi araçları kullanarak bir işi adım adım yürüten modeldir. Buradaki işi kod düzeltmek olduğu için kodlama ayarını seçtik; bu eşleme bizim kararımızdı.
Gemma’nın Ollama paketi önerilen değerleri zaten taşıyordu. Qwen paketi örnekleme değerlerini taşımadığı için ayarları her istekle gönderdik.
Qwen kartının 32.768 token çıktı önerisini uygulamadık; kart zor kod ve matematik için 81.920 token da öneriyor. Testte görev başına çıktı sınırı yoktu; iki model için tek sınır 131.072 token bağlamdı.
Beş bölümde neyi ölçtük?
#Talimat takibini, akıl yürütmeyi, kod doğruluğunu, uzun belgeden cevap bulmayı ve araçlarla proje düzeltmeyi ölçtük. Gizli test, modelin çözüm üretirken görmediği ve teslimden sonra kodunu sınamak için kullanılan kontroldür.
| Bölüm | Verilen iş | Başarı ölçüsü |
|---|---|---|
| Talimat | Her birinde üç kural olan 20 Türkçe iş istemi | İstemin bütün kurallarını geçmek |
| Akıl yürütme | İş hesabı, takvim, sıralama, tablo ve yetersiz bilgi soruları | 20 soruda doğru cevap sayısı |
| Kod | C#, JavaScript ve PHP’de ikişer görev | Bütün gizli testleri geçen görev sayısı |
| Uzun belge | Yaklaşık 93 bin ve 254 bin karakterlik iki şirket arşivi | Her arşivde 10 sorudan tam doğru cevaplananlar |
| Ajan | Dört hatalı küçük bir Node.js projesi | Özgün görünür testleri ve gizli testleri geçmek |
Talimat ve akıl yürütme Türkçeydi; diğer üç bölüm İngilizceydi. Şirket arşivleri gerçek müşteri verisi içermiyordu, test için hazırlanmış kayıtlardı.
Talimat takibinde tam puan ne anlama geliyor?
#Tam puan, verilen kurallara uyulduğunu gösteriyor; metnin içeriğinin doğru olduğunu göstermiyor. İki model de 20 istemin hepsini ve toplam 60 kuralı geçti.
Kelime ve madde sayısı, yasak kelimeler, yapılandırılmış yanıtların alan adları gibi koşulları kontrol ettik. Kaynaktaki belirli sayı, tarih ve adların cevapta bulunmasına da baktık. Bu bilgilerin doğru bağlamda kullanılıp kullanılmadığını puanlamadık.
İki model de bütün kuralları geçtiği için bu görevler aralarındaki farkı ortaya çıkaramadı. Gemma işi 7 dakika 19 saniyede, Qwen 11 dakika 4 saniyede bitirdi.
Qwen’in fazladan çözdüğü soru neydi?
#Qwen, altı kişinin çağrılma sırasını soran bulmacada cevabın belirlenemeyeceğini doğru buldu. Böylece 20 sorunun hepsini geçti; Gemma 19 doğru cevapta kaldı.
Sorudaki kurallara uyan beş sıralama vardı. Altıncı sırada Oya da Kaan da olabildiği için tek bir isim verilemiyordu. Gemma, “Ayşe, Kaan ile Burak arasında çağrılıyor” cümlesini bu üç kişinin art arda çağrıldığı şeklinde yorumladı ve “Oya” dedi.
Qwen doğru cevaba ulaşmak için yaklaşık 64.300 token düşünme metni üretti ve 9 dakika 36 saniye harcadı. Bölümün tamamı Qwen’de 33 dakika 31 saniye, Gemma’da 12 dakika 9 saniye sürdü. Diğer 19 soruyu ikisi de doğru cevapladı.
Kodda hangi model daha çok görevi eksiksiz çözdü?
#Gemma altı görevin dördünde bütün testleri geçti; Qwen bunu yalnızca Roma rakamları görevinde başardı. Başarılı sayılmak için kodun çalışması, beklenen testlerin hepsini geçmesi ve sürecin hatasız bitmesi gerekiyordu.
| Görev | Gemma 4 | Qwen3.6 |
|---|---|---|
| C#: matematik ifadelerini hesaplama | 88/88 | 0/88, derleme hatası |
| C#: değişiklikleri geri alabilen veri deposu | 35/35 | 0/35, derleme hatası |
| JavaScript: eşzamanlı işleri yöneten havuz | 35/35 | 28/35 |
| JavaScript: yardımcı işlevlerde hata düzeltme | 66/70 | 0/70, kod yok |
| PHP: Roma rakamlarıyla işlem | 93/93 | 93/93 |
| PHP: süreli ve kullanım sıralı önbellek | 34/47 | 15/47, süreç çöktü |
İki modelin altışar çözümü elle de incelendi. Test düzeneğine müdahale, istem dışı beklenti veya puanlayıcı hatası bulunmadı; puanlar değişmedi. Qwen’in eksikleri yalnızca yanlış hesaplardan oluşmuyordu: iki çözüm derlenmedi, bir görevde hiç kod çıkmadı.
C# çözümleri neden çalışmadı?
Matematik ifadelerini hesaplayan çözüm, iç sınıfın özel üyelerine dışarıdan erişmeye çalıştı. Veri deposu çözümü ise salt okunur bir alana yeniden değer atadı. Derleyici iki çözümü de reddetti; testler çalışamadı.
İş havuzunda ne eksikti?
Qwen’in JavaScript havuzu, işler başarıyla bitse de sonucu çağıran yere döndürmüyordu. Yedi başarısız testin ortak nedeni buydu. İnceleme sırasında eksik satır eklenen kopya 35/35 aldı; asıl puan 28/35 olarak korundu.
Hata düzeltme görevinde neden kod yoktu?
Qwen yaklaşık 108 bin karakter düşündükten sonra adres metnindeki + işaretinin çözülmesiyle ilgili aynı notu art arda 28 kez yazdı. Tekrarı durduran kural devreye girdi ve cevapta kod oluşmadı. Bu olay kesin kodlama ayarıyla yaşandı; genel ayarla ne olacağını denemedik.
PHP önbellekte 15/47 ne demek?
Qwen’in anahtarları sıralayan işlevi bir sonraki öğeye geçmeyi unuttu. Sonsuz döngü, PHP’nin 512 MB bellek sınırını tüketti ve süreç çöktü. İlk 15 test geçti, bir test başarısız oldu; kalan 31 test hiç çalışamadı ve kural gereği başarısız sayıldı.
Kodda PHP’de bulunmayan SplPriorityQueue::peek() çağrısı da vardı. Dolayısıyla 15/47 sonucunu, 32 ayrı yanlış cevap verilmiş gibi okumamak gerekiyor.
Gemma da iki görevi eksiksiz çözemedi. JavaScript çözümü özel anahtarları koruma ve seyrek dizileri karşılaştırma kontrollerinde kaldı. PHP önbelleği ise anahtar listesini yanlış yönde dolaştığı için 13 testi geçemedi.
Ana puana katılmayan iki ölçeklenme kontrolünde Gemma 2/2, Qwen 0/2 aldı. Qwen’in ilgili çözümleri çalışmadığı için bu kontrollerden de puan çıkmadı. Görevlerin test sayıları farklı olduğundan bunları toplayarak model puanı üretmedik.
Uzun belgelerde hangi sonuçları aldık?
#Qwen büyük belgede cevap yazdı ama 10 sorunun yalnızca dördünü tam doğru yanıtladı; Gemma hiç cevap yazamadı. Orta boy belgede ikisi de 8/10 aldı.
| Belge | Gemma: girdinin tuttuğu token | Qwen: girdinin tuttuğu token | Gemma sonucu | Qwen sonucu |
|---|---|---|---|---|
| Orta boy, yaklaşık 93 bin karakter | 31.787 | 32.291 | 8/10 | 8/10 |
| Büyük, yaklaşık 254 bin karakter | 84.019 | 85.398 | 0/10, cevap yok | 4/10 |
Büyük belge yüklendikten sonra düşünme ve cevaba Gemma’da 47.053, Qwen’de 45.674 token yer kalmıştı. Gemma kalan alanı düşünmeye harcadı ve 131.072 token sınırına ulaştı. Eski metni silerek devam etme kapalı olduğu için cevap yazamadan durdu.
Qwen daha az boş alanla cevabını tamamladı; yine de altı sorusu yanlış kaldı. Belge büyürken aranacak kayıtlar ve yapılacak hesaplar da arttı. Sonuçtaki değişimin ne kadarının yalnızca metin uzunluğundan geldiğini bu testle ayıramıyoruz.
Ajan görevini ikisi de bitirdi mi?
#Evet, iki model de küçük projedeki dört hatayı düzeltti ve 26 gizli testin hepsini geçti. Özgün projedeki dört görünür test de iki modelde geçti. Qwen 15 adımda, 2 dakika 17 saniyede; Gemma 25 adımda, 5 dakika 38 saniyede bitirdi.
Gemma çalışırken görünür test dosyasını değiştirmişti. Puanlama için özgün dosya geri kondu; bu yüzden değişiklik sonucu etkilemedi. Qwen görünür testlere dokunmadı.
Projede ilerlemeyen işlemleri durdurmak için ek kurallar vardı. Değişmeyen dosyalarda aynı araç çağrısının altıncı tekrarı, art arda dört araçsız yanıt veya üst üste üç bozuk araç çağrısı çalışmayı durduruyordu. Bu tek küçük proje, modellerin bütün ajan işlerinde nasıl davranacağını göstermiyor.
Hangi model işi daha kısa sürede bitirdi?
#Gemma talimat, akıl yürütme ve kodu; Qwen uzun belge ve ajan görevini daha kısa sürede bitirdi. Karşılaştırmada saniyedeki token sayısını kullanmadık.
Gemma, Ollama paketindeki MTP taslak modeli açık çalıştı. MTP’de küçük bir model sıradaki parçaları tahmin eder, ana model bu tahminleri birlikte kontrol ederek üretimi hızlandırır. Gemma’nın saniyede 200 token’ı aşan hızı bu hızlandırmadan ve JSON, kod gibi kalıplı çıktıdan geliyor. MTP kapalıyken aynı model bu kartta saniyede 104–109 token yazıyor; Qwen paketinde taslak model yok. Ayrıntılar Lokal AI Modellerde MTP Nedir ve Çıktı Türü Hızı Etkiler mi? yazısında.
Gemma üç bölümü, Qwen iki bölümü daha kısa sürede bitirdi
Bölüm süreleri en yakın saniyeye yuvarlandı; uzun belge süresi iki belgenin toplamıdır.
- Gemma 4
- Qwen3.6
Talimat
Akıl yürütme
Kod
Uzun belge
Ajan
Tablo olarak göster
| Bölüm | Gemma 4 | Qwen3.6 |
|---|---|---|
| Talimat | 7 dk 19 sn | 11 dk 4 sn |
| Akıl yürütme | 12 dk 9 sn | 33 dk 31 sn |
| Kod | 5 dk 23 sn | 17 dk 18 sn |
| Uzun belge | 9 dk 42 sn | 9 dk 20 sn |
| Ajan | 5 dk 38 sn | 2 dk 17 sn |
Süreyi teslim edilen sonuçla birlikte değerlendirmek gerekiyor. Gemma büyük belgede daha uzun çalışmasına rağmen cevap yazamadı. Ajan görevinde ise ikisi de bütün testleri geçtiği için Qwen’in kısa süresi aynı başarılı sonuca karşılık geliyor.
Sonuçların birlikte anlattığı ne?
#Bu görevlerde tek bir model her alanda öne çıkmadı; doğru cevap, çalışan kod ve bekleme süresi ayrı ayrı değerlendirilmeli. Akıl yürütmedeki tek doğru cevap farkı ile koddaki eksiksiz görev farkı aynı ölçü değil.
Akıl yürütme:
Qwen bir soruyu daha doğru cevapladı; bölüm süresi daha uzundu.
Kod:
Gemma dört görevi, Qwen bir görevi bütün testleri geçerek çözdü.
Belge:
Orta boyda sonuç eşitti; büyük belgede yalnız Qwen cevap yazdı, dört doğru cevapta kaldı.
Küçük proje:
İkisi de bitirdi; Qwen daha az adımda ve daha kısa sürede tamamladı.
Kendi işinizde hangisinin önemli olduğuna siz karar verirsiniz. Büyük belgede bunu açıkça gördük: cevap yazabilmek ile doğru cevap vermek aynı şey değil.
Bu testin sınırları neler?
#Tek donanım, her görevin tek çalıştırması ve küçük bir görev seti sonuçların kapsamını sınırlıyor. Bu kayıtlardan genel model üstünlüğü veya istatistiksel anlamlılık iddiası çıkarmıyoruz.
Bu sınırlar özellikle satın alma ve kurulum kararında önemli. Burada geçen bir görev, şirketinizin farklı belge veya yazılımlarında aynı sonucun alınacağını kanıtlamıyor.
İşletmeniz için nasıl bir deneme hazırlamalısınız?
#Kendi belgelerinizden ve işlerinizden küçük bir görev seti seçip doğruluğu, tamamlanmayı ve süreyi birlikte ölçmelisiniz. Bu testteki farklar, yalnızca modelin cevap vermesine bakmanın yeterli olmadığını gösteriyor.
- Belge görevinde cevap yazabiliyor mu, kaç cevabı doğrulanmış kayıtlarla uyuşuyor?
- Ürettiği kod çalışıyor ve sizin testlerinizi geçiyor mu?
- Projede işin bittiğini söylediğinde bütün kontroller gerçekten geçiyor mu?
- Aynı işi tekrar verdiğinizde sonuç değişiyor mu?
- Doğru sonuç için beklediğiniz süre iş akışınıza uyuyor mu?
Yerel yapay zekâ kurulumu sırasında model seçimini belge erişimi ve kullanıcı yetkileriyle birlikte planlamak gerekiyor. Yapay zekâ danışmanlığı hangi işlerin ölçülmeye değer olduğunu belirlemeye, yazılım geliştirme ise modelin mevcut uygulamalara bağlanmasına yardımcı olur. Kabul edeceğiniz başarı ölçüsünü bu çalışmalardan önce belirleyin.
Testi nasıl tekrarlayabilirsiniz?
#Depoyu indirip BASLAT.md adımlarını izleyerek testi kendi makinenizde çalıştırabilirsiniz. Önce modeli çağırmadan düzeneği sınayan python calistir.py --mock komutunu, ardından python calistir.py --on-kontrol komutunu kullanın. Asıl çalıştırma python calistir.py ile başlıyor; bizde yalnız Qwen koşusu yaklaşık 1 saat 20 dakika sürdü.
// açık test verisi
- kod · MIT
- veri · CC BY 4.0
metotbilisim/gemma4-qwen36-onerilen-ayarlar-testi
github.com
Görevlerden ham cevaplara kadar karşılaştırmanın kayıtları açık
Sonuçların nasıl puanlandığını inceleyebilir ve aynı görevleri kendi kurulumunuzda deneyebilirsiniz.
// depoda neler var
Görevler:
Beş bölümün istemleri, soruları ve belgeleri.
Puanlama:
Puanlayıcılar ve modele gösterilmeyen gizli testler.
Çalıştırma dosyaları:
Programlar, ayar kayıtları ve dosya özetlerini tutan manifest.
Cevaplar:
İki modelin ham yanıtları, düşünme metinleri ve görev kayıtları.
İnceleme:
Sonuç raporu ve kod çözümlerinin elle inceleme notları.
git clone https://github.com/metotbilisim/gemma4-qwen36-onerilen-ayarlar-testi.gitBaşka bir modeli denerken gizli testleri modele göstermeyin. Kayıtlar 25 Ekim 2026 tarihli sonuçları içeriyor; aynı sayıları yeniden alacağınızı garanti etmiyor.
Kaynaklar ve doğrulama
#Puanlar otomatik sonuç raporuna, hata açıklamaları iki modelin kod çözümlerine ait elle inceleme notlarına dayanıyor. Üretici ayarlarının ve kullanılan Qwen paketinin kaynakları da erişime açık.
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinGemma 4 mü Qwen3.6 mı daha iyi sonuç aldı?
Sonuç işe göre değişti. Talimatta ikisi de 20/20 aldı. Akıl yürütmede Qwen 20/20, Gemma 19/20; kodda Gemma 4/6, Qwen 1/6 aldı. Büyük belgede Qwen 4/10 aldı, Gemma cevap yazamadı. Bu küçük testten genel model sıralaması çıkarmıyoruz.
Qwen'in hangi önerilen ayarlarını kullandınız?
Model kartındaki kesin kodlama ayarını kod ve ajan görevlerine, genel ayarı diğer üç bölüme uyguladık. Bu eşleme bizim kararımızdı. Kartın çıktı uzunluğu önerisini uygulamadık; görev başına çıktı sınırı koymadık.
Qwen kodda neden yalnızca bir görevi tamamen geçti?
İki C# çözümü derlenmedi. JavaScript iş havuzu sonucu döndürmedi; hata düzeltme görevinde ise model tekrara düştü ve kod yazamadı. PHP önbellek çözümü sonsuz döngüyle çöktü. Yalnızca Roma rakamları çözümü bütün testleri geçti.
Akıl yürütmede süre farkı neydi?
Gemma 12 dakika 9 saniyede, Qwen 33 dakika 31 saniyede bitirdi. Qwen'in fazladan doğru cevapladığı sıralama bulmacası tek başına 9 dakika 36 saniye sürdü. Diğer 19 soruyu iki model de doğru cevapladı.
Qwen paketi RTX 3090 belleğine sığdı mı?
Evet. Ön kontrolde model tamamen ekran kartında çalıştı ve yaklaşık 20,4 GB yer tuttu. Testte Unsloth'un Ollama'da 18 GB tutan sıkıştırılmış paketini kullandık; sonuçlar bu paket için geçerli.
Büyük belgede Gemma neden cevap yazamadı?
Belgeden sonra kalan alanı düşünmeye harcadı ve bağlam sınırına ulaştı. Cevap yazamadığı için 0/10 aldı. Qwen cevap yazdı ama 10 sorunun yalnızca 4'ünü tam doğru yanıtladı.
Küçük projeyi hangi model bitirdi?
İkisi de dört hatayı düzeltti ve 26 gizli testin hepsini geçti. Qwen 15 adımda, 2 dakika 17 saniyede bitirdi. Gemma 25 adımda, 5 dakika 38 saniyede bitirdi.
Bu sonuçlar bütün işler için geçerli mi?
Hayır. Tek donanım, her görevin tek çalıştırması ve küçük bir görev seti kullandık. Türkçeyi yalnızca talimat ve akıl yürütmede ölçtük. Kod, uzun belge ve proje görevleri İngilizceydi.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen lokal (yerel) yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
- yazılım
Özel Yazılım ve Web Uygulaması Geliştirme
Web uygulaması, özel işlev ve entegrasyon ihtiyaçlarınızı birlikte değerlendirelim.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.