10 dk okuma
Lokal AI Modellerde MTP Nedir ve Çıktı Türü Hızı Etkiler mi?
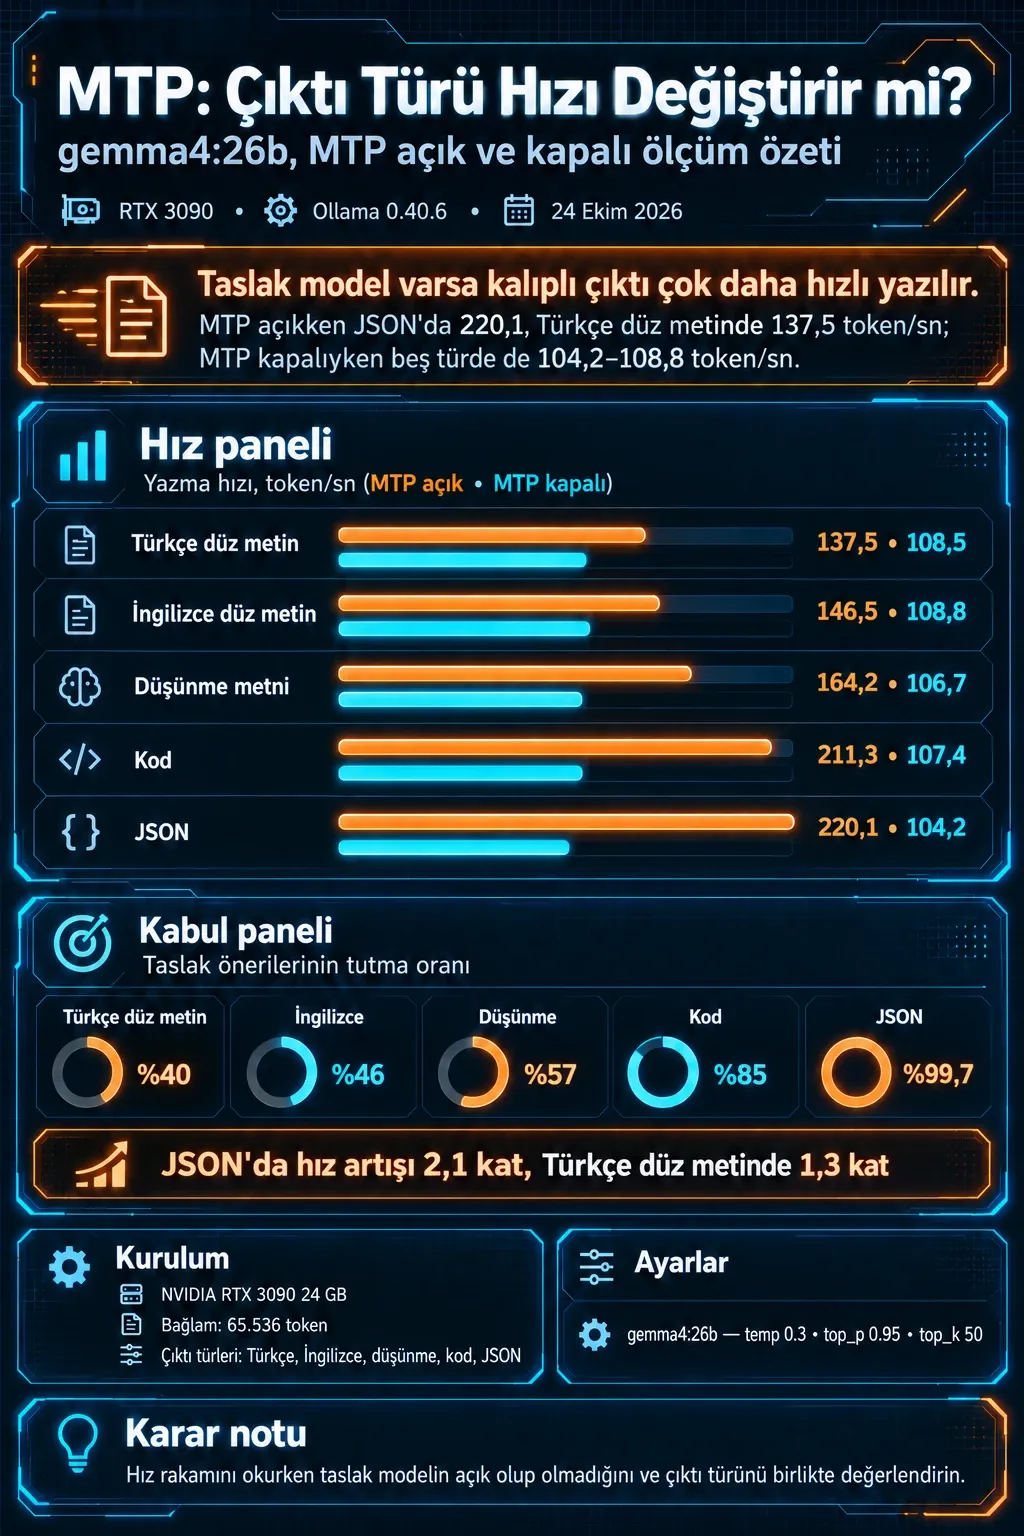
MTP, ana modelin küçük bir taslak modelin önerdiği token'ları tek adımda doğruladığı bir hızlandırma yöntemidir ve taslak model varsa çıktı türü hızı ciddi etkiler. Aynı gemma4:26b aynı RTX 3090'da JSON'da 220,1, Türkçe düz metinde 137,5 token/sn yazdı; MTP kapalıyken her türde 104–109 token/sn'de kaldı.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- Aynı gemma4:26b aynı RTX 3090'da MTP açıkken JSON'da 220,1, kodda 211,3, Türkçe düz metinde 137,5 token/sn yazdı; MTP kapalıyken beş çıktı türünde de 104,2 ile 108,8 token/sn arasında kaldı.
- Taslak modelin önerilerinin tutma oranı JSON'da %99,7, Türkçe düz metinde %41,7 ve %37,7 çıktı; hız farkı bu orandan geliyor. Taslak modeli olmayan Qwen3.6-35B-A3B'de düz metin de JSON da yaklaşık 130 token/sn yazıldı.
- Önceki Gemma testlerimizdeki 216–220 token/sn rakamları MTP açıkken ölçüldü. Qwen3.5 9B ile farkın neredeyse tamamı MTP'den geliyor: aynı altı sağlık görevinde MTP kapalı Gemma 104,1, Qwen 100,7 token/sn yazdı (oran 1,03).
MTP nedir ve çıktı türü hızı etkiler mi?
#MTP (multi-token prediction), ana modelin yanında çalışan küçük bir taslak modelin sonraki birkaç token’ı önceden tahmin ettiği ve ana modelin bu tahminleri tek adımda doğruladığı bir hızlandırma yöntemidir. Evet, taslak model varsa çıktı türü hızı ciddi etkiler: tek RTX 3090’da aynı gemma4:26b JSON’da 220,1, Türkçe düz metinde 137,5 token/sn yazdı. MTP’yi kapattığımızda aynı model aynı kartta her çıktı türünde 104–109 token/sn’de kaldı.
Bu ölçümü, önceki Gemma testlerimizdeki yüksek yazma hızının (216–220 token/sn) nedenini aradığımız için yaptık. Hızın modelden değil, Ollama paketindeki taslak modelle testlerimizin çıktı türünden geldiğini gördük.
JSON yazma hızı
MTP açık220,1 token/snMTP kapalı104,2 token/sn2,11 kat
Kod yazma hızı
MTP açık211,3 token/snMTP kapalı107,4 token/sn1,97 kat
Türkçe düz metin yazma hızı
MTP açık137,5 token/snMTP kapalı108,5 token/sn1,27 kat
Token, modelin metni işlediği küçük birimdir ve yazma hızı saniyede kaç token yazıldığını gösterir.
MTP ve speculative decoding nedir?
#Speculative decoding (tahminli çözme), büyük modelin her token’ı tek tek üretmesi yerine küçük bir modelin önerdiği token’ları büyük modelin toplu doğrulamasıdır. Yöntemin temel makalesi Leviathan, Kalman ve Matias’a ait (ICML 2023). MTP, aynı fikrin Gemma 4’teki uygulaması: Google’ın belgesine göre taslak model ana modelin gömme tablosunu ve son katman çıktılarını kullanıyor, yani ana modele bağlı çalışıyor.
Ollama’nın gemma4:26b paketinde ana model (17 GB) ve görsel modülün (1,2 GB) yanında 462 MB’lık bir draft katmanı var; paket sayfası bu katman için draft_num_predict değerini 3 gösteriyor. Bizim kurulumumuzda Ollama günlüğü modelin --spec-type draft-mtp --spec-draft-n-max 3 ile yüklendiğini gösterdi: taslak her adımda en çok 3 token öneriyor.
Taslak önerir:
Taslak model sıradaki en çok 3 token’ı hızla tahmin eder.
Ana model doğrular:
Ana model üç öneriyi tek adımda, yan yana kontrol eder.
Tutan öneriler kalır:
Ana modelin kendi seçeceği token’la aynı çıkan öneriler çıktıya geçer. İlk tutmayan öneride ana model doğru token’ı yazar ve döngü oradan sürer.
Adım uzunluğu belli olur:
Ana model bir adımda 1 ile 4 token yazar: tutan önerilerin sayısı artı kendi token’ı. Günlükteki ortalama adım uzunluğu (mean len) bu sayının ortalamasıdır.
Günlükteki rakamlar basit bir hesapla örtüşüyor: kabul oranı çarpı 3, artı 1. JSON’da 0,997 × 3 + 1 ≈ 3,99, Türkçe düz metinde 0,417 × 3 + 1 ≈ 2,25 çıktı; ikisi de günlükte yazan adım uzunluğu.
Yöntemin çıktıyı değiştirmediği iddiası iki kaynağa dayanıyor. Leviathan ve arkadaşlarının özeti, yöntemin dağılımı değiştirmeden hızlandırdığını yazıyor; Google Research’ün geriye bakış yazısı aynı çıktı dağılımı garantisini yineliyor. Google’ın Gemma 4 duyurusu ise taslak modeller için “kalite kaybı yok” diyor. Biz çıktı kalitesini bu ölçümde karşılaştırmadık; yalnızca hızı ölçtük.
Çıktı türü hızı neden değiştiriyor?
#Çünkü taslak modelin önerisi, çıktı kalıplıysa sık, serbest metinse seyrek tutuyor. JSON’da anahtar adları, tırnaklar, virgüller ve parantezler önceden bellidir; kodda girinti ve def, return gibi sözcükler sürekli tekrar eder. Türkçe düz metinde her kelime için birkaç makul seçenek var ve taslak çoğu zaman ana modelden farklı bir kelime seçiyor. Kalıplılığı ayrıca ölçmedik; bu, kabul oranlarının sıralamasıyla uyumlu olan yorumumuz.
JSON’da taslağın neredeyse her önerisi tuttu, Türkçe düz metinde yarısından azı
Taslak model önerilerinin ana model tarafından kabul oranı (%), MTP açık. JSON’un 2. denemesinde günlük satırı okunamadı; çıktı 1. denemeyle birebir aynıydı.
- 1. deneme
- 2. deneme
Türkçe düz metin
İngilizce düz metin
Düşünme metni
KodPython
JSON
Tablo olarak göster
| Çıktı türü | 1. deneme | 2. deneme |
|---|---|---|
| Türkçe düz metin | %41,7 | %37,7 |
| İngilizce düz metin | %46,3 | %45,4 |
| Düşünme metni | %57,7 | %55,9 |
| Kod (Python) | %84,0 | %86,5 |
| JSON | %99,7 | günlük yok |
Ortalama adım uzunluğu aynı sırayı izliyor: Türkçe düz metinde 2,25 ve 2,13, düşünme metninde 2,73 ve 2,67, kodda 3,52 ve 3,59, JSON’da 3,99. JSON’da ana model her adımda neredeyse dört token yazıyor, Türkçe düz metinde iki civarında.
Aynı farkı öneri sayılarında da görüyoruz. Türkçe düz metinde taslak 1.065 token önerdi, 444’ü tuttu; JSON’da 1.032 öneriden 1.029’u tuttu.
JSON’da 1.032 önerinin 1.029’u tuttu, Türkçe düz metinde 1.065’in 444’ü
- Kabul edilen
- Reddedilen
Türkçe düz metin
JSON
Tablo olarak göster
| Çıktı türü | Kabul edilen | Reddedilen |
|---|---|---|
| Türkçe düz metin | 444 | 621 |
| JSON | 1.029 | 3 |
Türkçe denemede ana model 621 öneriyi reddetti. Reddedilen her öneri adımı o noktada keser ve ana model o adımda daha az token yazar. JSON’da reddedilen öneri sayısı 3’te kaldı.
MTP açıkken ve kapalıyken gemma4:26b ne kadar hızlı yazdı?
#Beş çıktı türünün hepsinde MTP açık sürüm kapalıdan hızlıydı; fark Türkçe düz metinde 1,27 kat, JSON’da 2,11 kat oldu. İki sürümü aynı ağırlıklarla kurduk: gemma4:26b Ollama paketi MTP açık, gemma4-nomtp ise aynı ana modeli ve görsel modülü taşıyan, yalnızca DRAFT satırı çıkarılmış bir Modelfile ile elle oluşturduğumuz sürüm. Ollama günlüğünde gemma4-nomtp’nin yükleme komutunda --spec-type yok; taslak model gerçekten devre dışıydı.
| Ayar | Değer |
|---|---|
| Ekran kartı | RTX 3090, 24 GB |
| Çalıştırma yazılımı | Ollama 0.40.6 |
| Bağlam penceresi | 65.536 token |
| Örnekleme | sıcaklık 0,3, top_p 0,95, top_k 50 |
| Çıktı türleri | Türkçe düz metin, İngilizce düz metin, düşünme metni, Python kodu, JSON |
| JSON görevi | Sağlık testimizdeki 40 hasta mesajını sınıflandırma istemi |
| Tekrar | Her tür ve her sürüm için 2 deneme |
Grafikte iki denemenin ortalaması var. Tek tek değerler ham veride duruyor; örneğin Türkçe düz metinde MTP açık 140,7 ve 134,2 token/sn çıktı.
MTP açıkken hız 137,5’ten 220,1’e çıktı, kapalıyken 104–109’da kaldı
Yazma hızı, token/sn, iki denemenin ortalaması. gemma4:26b, tek RTX 3090.
- MTP açık
- MTP kapalı
Türkçe düz metin
İngilizce düz metin
Düşünme metniiç ses
KodPython
JSON
Tablo olarak göster
| Çıktı türü | MTP açık | MTP kapalı |
|---|---|---|
| Türkçe düz metin | 137,5 | 108,5 |
| İngilizce düz metin | 146,5 | 108,8 |
| Düşünme metni (iç ses) | 164,2 | 106,7 |
| Kod (Python) | 211,3 | 107,4 |
| JSON | 220,1 | 104,2 |
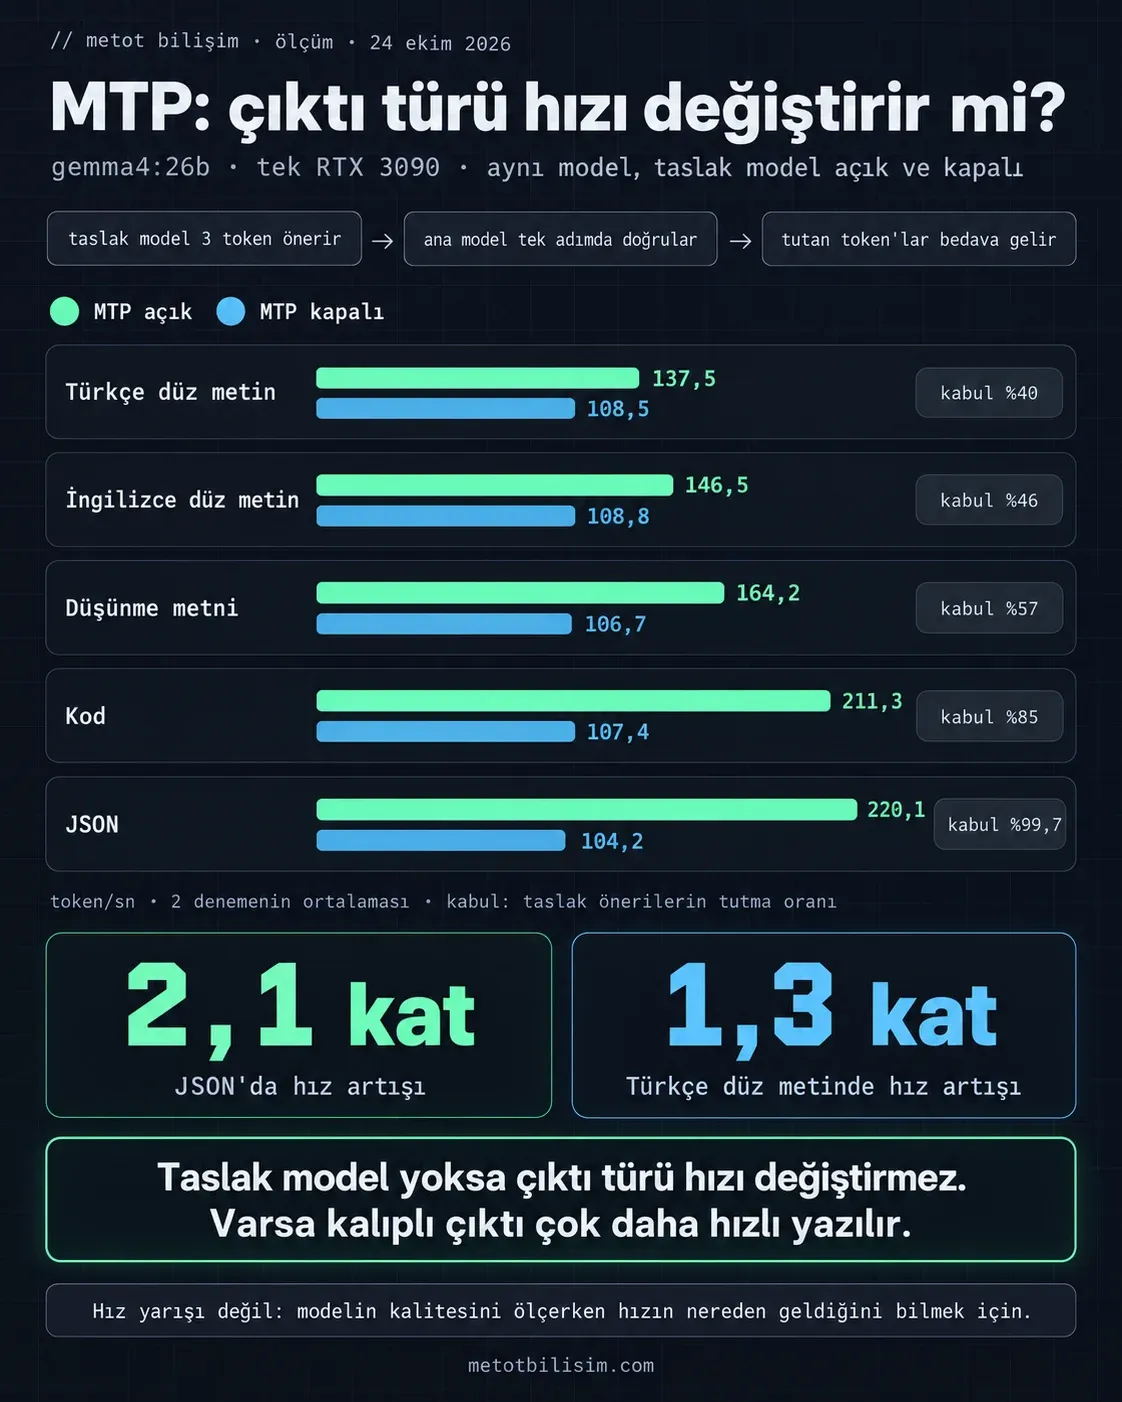
MTP kapalıyken hız çıktı türüne bağlı değil: beş türün tamamı 104,2 ile 108,8 token/sn arasında. MTP açıkken adım başına JSON’da neredeyse 4 token yazılmasına rağmen hız 4 kat değil 2,11 kat arttı. Taslağın kendi çalışması ve doğrulama adımının tek token’lık adımdan ağır olması bu farkı açıklayabilir; bunu ayrıca ölçmedik.
Taslak modeli olmayan modelde çıktı türü hızı değiştirdi mi?
#Hayır: taslak modeli olmayan Qwen3.6-35B-A3B’de düz metin 131,3 ve 131,2, JSON 129,3 ve 128,9 token/sn çıktı. Kontrol olarak bu modeli aynı gün ve aynı ayarlarla ölçtük (UD-IQ4_XS kuantizasyon, 256 uzmandan 8’i çalışıyor).
Qwen modelleri JSON’da 100–129 token/sn yazdı; Gemma MTP açıkken 220’ye çıktı
JSON çıktısında yazma hızı, token/sn. Qwen3.5 9B değeri, sağlık testimizdeki altı JSON görevinin ortalaması (aynı görevlerde MTP kapalı Gemma 104,1); Qwen3.6 değeri 1. deneme (2. deneme 128,9).
- Yazma hızı
Gemma 4 26B, MTP açıkJSON, ortalama
Gemma 4 26B, MTP kapalıJSON, ortalama
Qwen3.6-35B-A3BJSON, 1. deneme
Qwen3.5 9BJSON, sağlık testi
Tablo olarak göster
| Model | Yazma hızı |
|---|---|
| Gemma 4 26B, MTP açık (JSON, ortalama) | 220,1 |
| Gemma 4 26B, MTP kapalı (JSON, ortalama) | 104,2 |
| Qwen3.6-35B-A3B (JSON, 1. deneme) | 129,3 |
| Qwen3.5 9B (JSON, sağlık testi) | 100,7 |
Qwen3.5 9B’yi bu ölçüm için ayrıca koşmadık; 100,7, sağlık testimizdeki ölçümden geliyor ve günlükte --spec-type yok, yani taslak modeli yok. Aynı sağlık testinin altı görevinde MTP kapalı Gemma 104,1 token/sn yazdı; bu, yukarıdaki 104,2’ye çok yakın. Qwen3.6’da çıktı türü hızı değiştirmedi; Gemma’da hızı, çıktı türüyle taslak modelin birleşimi belirliyor.
Önceki testlerimizdeki hız rakamları MTP’li miydi?
#Evet: hukuk, sağlık ve Gemma–LFM testlerimizin üçünde de gemma4:26b MTP açık yüklendi; Ollama günlüklerinde yükleme komutunda --spec-type draft-mtp var. Bu testlerin görevleri JSON ve kod çıktısı verdiği için taslak modelin en çok işe yaradığı çıktı türleriydi.
Hukuk ve sağlık testleri:
Hukuk bürosu ve sağlık kuruluşu testlerinde Gemma 4 yaklaşık 200 ve 218 token/sn yazdı. İkisinde de görevler JSON çıktılıydı ve rakamlar MTP açıkken ölçüldü.
Gemma ve LFM karşılaştırması:
Gemma 4 ile LFM2.5 testinde 222’ye karşı 216 token/sn bulmuştuk. LFM2.5 paketinde taslak model yok; yani LFM’nin ham hızını Gemma’nın MTP’li hızıyla karşılaştırmıştık.
Qwen3.5 9B ve Gemma:
Qwen3.5 9B testinde 100,7’ye karşı 219,4 token/sn bulmuştuk. Aynı altı görevde MTP kapalı Gemma 104,1 token/sn yazdı; farkın neredeyse tamamı MTP’den geliyor.
Qwen yazısının ilk sürümü bu farkı uzmanlar karışımı (MoE) yapısına bağlamış, bant genişliği hesabıyla da 2,4 katlık bir oran bulmuştuk. O açıklama yanlıştı ve Qwen yazısını düzelttik. MTP kapalı Gemma ile Qwen3.5 9B arasındaki oran aynı altı görevde 1,03 çıktı (104,1’e karşı 100,7); MTP açık ile kapalı Gemma arasındaki oran 2,11. Hız farkını yaratan asıl etken taslak model. Gemma’nın her token’da daha az parametre çalıştırması doğru olmaya devam ediyor, ama MoE avantajının ölçümde neden görünmediğini araştırmadık.
LFM tarafında da bir düzeltme gerekiyor. MTP kapalı Gemma’yı LFM2.5 ile yeniden yarıştırmadık. “Yazma hızında iki model neredeyse eşit” sonucunu bu yüzden aynı koşullarda ölçülmüş bir eşitlik olarak okumayın.
Kendi modelinizde hız kıyaslarken neye bakmalı?
#Önce modelinizde taslak model olup olmadığına bakın, sonra modelleri aynı çıktı türüyle ölçün. Ollama’da modelin Modelfile’ını şu komutla görebilirsiniz:
ollama show --modelfile <model>Çıktıda DRAFT satırı varsa paket bir taslak model taşıyor. Modeli yüklerken Ollama günlüğündeki yükleme komutunda --spec-type görüyorsanız taslak model çalışıyor demektir. Bu işaretleri bizim gemma4:26b kurulumumuzda gördük; başka paketlerde ve çalıştırıcılarda adlar farklı olabilir.
Aynı çıktı türüyle ölçün:
Bir model JSON, öteki düz metin yazıyorsa hız kıyası modelleri değil çıktıyı karşılaştırır. İki modele de aynı türde bir görev verin.
MTP durumunu rakamın yanına yazın:
Bizim 220,1’e karşı 104,2’miz aynı modelin iki hâli. Taslak model açık mı kapalı mı yazmadan paylaşılan bir hız rakamı eksiktir.
Hızı tek ölçüt yapmayın:
Biz hız yarışı yapmıyoruz; testlerimizin amacı modellerin kalitesini ölçmek. Hız topladığımız verilerden yalnızca biri: Gemma–LFM testinde süre farkını hız değil, harcanan token sayısı belirlemişti.
Bu ölçümün sınırları neler?
#Bu bir bilimsel yayın değil; tek gün, tek kart ve tek Ollama sürümüyle yapılmış kısa bir mühendislik ölçümü. Sonuçları şu sınırlarla okuyun.
Bir modeli kendi donanımınızda ve kendi belgelerinizle ölçmek, yerel yapay zekâ kurulumunda yaptığımız işin parçası: kurulumda modeli kuruluşun örnek belgeleriyle ve doğru cevabı baştan bilinen görevlerle sınıyoruz.
Bu testi kendim nasıl tekrarlarım?
#Ölçüm betiği iki modeli art arda koşar (python mtp_olcum.py gemma4:26b gemma4-nomtp); MTP’siz modeli Modelfile.nomtp ile siz de oluşturabilirsiniz.
// açık test verisi
- kod · MIT
- veri · CC BY 4.0
metotbilisim/mtp-cikti-turu-hiz-olcumu
github.com
MTP ölçümünün betikleri, MTP’siz Modelfile’ı ve ham sonuçları açık
Ölçüm tek günde ve tek kartta yapıldı; başka bir kartta ya da sürümde sonuç değişir. Betiği kendi makinenizde çalıştırıp hızı ve taslak kabul oranını doğrudan okuyabilirsiniz.
Betikler JSON istemini sağlık testi deposundan okur; README, bu yolu nasıl değiştireceğinizi anlatıyor.
// depoda neler var
Ölçüm betikleri:
mtp_olcum.py,json_vs_duz.pyvehiz.py.MTP’siz Modelfile:
Modelfile.nomtp, aynı ağırlıklarla taslak modeli bağlayan satırı çıkarır; içindeki dosya yollarını kendi kurulumunuza göre değiştirmeniz gerekir.Ham sonuçlar:
mtp_olcum.jsoniçinde 20 ölçümün token sayısı, hızı ve taslak kabul oranı var.Kontrol ölçümü:
hiz-sonuc.json, taslak modeli olmayan Qwen3.6-35B-A3B’nin sonucunu içerir.Ölçüm notları:
OLCUM.mddüzeneği, tabloları ve JSON’un 2. denemesindeki okunamayan günlük satırını yazar.
git clone https://github.com/metotbilisim/mtp-cikti-turu-hiz-olcumu.gitKullanırken kaynak olarak Metot Bilişim (metotbilisim.com) belirtmeniz yeterli.
Kaynaklar
#- Fast Inference from Transformers via Speculative Decoding — arXiv 2211.17192 (Leviathan, Kalman, Matias)arxiv.org
- Looking back at speculative decoding — Google Researchresearch.google
- Speed-up Gemma 4 with Multi-Token Prediction — Google AI for Developersai.google.dev
- Accelerating Gemma 4: faster inference with multi-token prediction drafters — Googleblog.google
- gemma4:26b — Ollamaollama.com
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinMTP (multi-token prediction) nedir?
MTP, ana modelin yanında çalışan küçük bir taslak modelin sonraki birkaç token'ı önceden önerdiği, ana modelin bu önerileri tek adımda doğruladığı bir hızlandırma yöntemidir. Ollama'nın gemma4:26b paketinde 462 MB'lık bir taslak katmanı var ve taslak her adımda en çok 3 token öneriyor. Ana model tutan önerileri kabul eder, tutmayanın yerine kendi token'ını yazar.
Speculative decoding çıktıyı değiştirir mi?
Kaynaklara göre değiştirmez. Leviathan ve diğerlerinin 2023 tarihli makalesi yöntemin dağılımı değiştirmeden hızlandırdığını yazıyor; Google da Gemma 4 taslak modelleri için kalite kaybı olmadığını söylüyor. Biz bu ölçümde çıktı kalitesini karşılaştırmadık, yalnızca yazma hızını ve taslak kabul oranını ölçtük.
Çıktı türü neden hızı etkiler?
Taslak modelin önerisinin tutma ihtimali çıktının ne kadar kalıplı olduğuna bağlı. Testimizde JSON'da önerilerin %99,7'si tuttu ve ana model her adımda neredeyse 4 token yazdı (3,99); Türkçe düz metinde kabul oranı %41,7 ve %37,7, adım uzunluğu 2,25 ve 2,13 çıktı. Bu yüzden aynı model JSON'da 220,1, Türkçe düz metinde 137,5 token/sn yazdı.
MTP kapalıyken gemma4:26b kaç token/sn yazar?
Aynı kartta (RTX 3090) ve aynı ayarlarla 104,2 ile 108,8 token/sn arasında; çıktı türü fark etmedi. Türkçe düz metinde 108,5, İngilizce düz metinde 108,8, düşünme metninde 106,7, kodda 107,4, JSON'da 104,2 ölçtük. MTP açıkken aynı değerler 137,5 ile 220,1 arasındaydı.
Modelimde taslak model olup olmadığını nasıl anlarım?
Ollama'da `ollama show --modelfile <model>` çıktısında `DRAFT` satırına bakın; ya da modeli yüklerken Ollama günlüğündeki yükleme komutunda `--spec-type` ifadesini arayın. Bizim gemma4:26b kurulumumuzda ikisini de gördük, MTP kapalı sürümde ikisi de yoktu. Başka paket ve sürümlerde adlar değişebilir.
Taslak modeli olmayan modellerde çıktı türü hızı değiştirir mi?
Testimizde değiştirmedi. Taslak modeli olmayan Qwen3.6-35B-A3B aynı kartta düz metinde 131,3 ve 131,2, JSON'da 129,3 ve 128,9 token/sn yazdı. Çıktı türünün hızı etkilemesi, taslak modelin varlığına bağlı görünüyor.
Önceki testlerinizdeki yüksek hız rakamları neden böyleydi?
Hukuk, sağlık ve Gemma–LFM testlerinde gemma4:26b MTP açık yüklendi ve görevler JSON ya da kod çıktısı veriyordu. Bu iki koşul birleşince yaklaşık 216–220 token/sn çıktı. MTP kapalıyken aynı model aynı kartta yaklaşık 104–109 token/sn yazıyor.
Hız kıyaslarken nelere dikkat etmeliyim?
Üç şeye: modelin taslak modelinin açık olup olmadığına, ölçümde aynı çıktı türünün kullanılıp kullanılmadığına ve hızın tek ölçüt olmadığına. Bizim ölçümümüzde JSON'da MTP açık sürüm kapalıdan 2,11 kat hızlıydı, Türkçe düz metinde yalnızca 1,27 kat. Gemma–LFM testimizde ise süre farkını hız değil, harcanan token sayısı belirlemişti.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.