8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- Aynı 24 GB'lık RTX 3090'da qwen3.5:9b ekran kartı belleğinin 9,7–10,0 GB'ını, gemma4:26b 20,5–21,4 GB'ını kullandı. Dosya boyutları 6,6 GB ve 18 GB'tı; 65.536 token'lık bağlam yaklaşık 3 GB ekledi.
- Küçük model daha hızlı çıkmadı: taslak model olmadan qwen3.5:9b 100,7, gemma4:26b 104,1 token/sn yazdı. MTP açıkken Gemma 219,4 token/sn'ye çıktı ve altı görevi 1 dk 3,7 sn'de bitirdi.
- Ölçümlerimiz tek kullanıcılıdır. Eş zamanlı kullanıcı kapasitesini ve yalnız işlemciyle hızı ölçmedik; bu bölümleri Ollama, llama.cpp ve vLLM dokümanlarına dayanarak anlattık.
Lokal yapay zekâ sunucusu nedir?
#Lokal (yerel) yapay zekâ sunucusu, dil modelini ve onunla birlikte çalışan arayüz ile belge aramasını kurumunuzun ağında çalıştıran makinedir. Sıradan bir dosya sunucusundan farkı ekran kartıdır. Dosya sunucusunda disk ve ağ hızı öne çıkar; burada modelin çalıştığı ekran kartı belleği belirleyicidir.
Makine bir iş istasyonu da olabilir, raftaki bir sunucu da. Önemli olan model, bağlam ve beklenen kullanıcı yükünün aynı donanıma sığmasıdır.
Donanımı hangi etkenler belirler?
#Donanımı altı etken belirler: model boyutu, kuantizasyon, bağlam penceresi, eş zamanlı kullanıcı sayısı, beklenen yanıt süresi ve belge hacmi. Bu liste, lokal yapay zekâ kurulum hizmeti sayfamızdaki donanım ve maliyet etkenlerine dayanır.
- Model boyutu:Parametre sayısı arttıkça model dosyası ve kartta tuttuğu yer büyür.
- Kuantizasyon:Ağırlıkların kaç bit ile saklandığı dosya boyutunu değiştirir; bu yazıdaki ölçümde Q4_K_M (4 bit civarı) kullandık.
- Bağlam penceresi:Modele aynı anda verdiğiniz metin uzadıkça bellek ihtiyacı artar.
- Eş zamanlı kullanıcı:Aynı anda işlenen istek sayısı belleği ve yanıt süresini etkiler.
- Yanıt süresi beklentisi:Bekleyebileceğiniz süre, gereken kartı ve modeli belirler.
- Belge hacmi:Belge okuma ve arama katmanı işlemci, bellek ve disk ister.
Bu etkenlerin ağırlığı işten işe değişir. Kısa soru-cevap yapan bir asistanla yüzlerce sayfalık dosya özetleyen bir sistem aynı donanımı istemez. Bu yüzden satın almadan önce mevcut sunucuya ve hedef işe bakmak, ekran kartı modeli seçmekten önce gelir.
Ekran kartı belleği (VRAM) neden belirleyici?
#Model ve bağlam önbelleği aynı belleğe sığmalıdır; sığmazsa sistem yavaşlar. Ollama dokümanına göre bir model yalnız ekran kartında, yalnız sistem belleğinde ya da ikisine bölünmüş hâlde yüklenebilir. ollama ps komutunun PROCESSOR sütunu bunu gösterir. “100% GPU” modelin tamamen kartta olduğunu, “48%/52% CPU/GPU” gibi bir değer bölünmüş yüklemeyi anlatır.
llama.cpp deposu da CPU ve GPU karma çalışmayı anıyor; amacı, toplam VRAM’den büyük modelleri kısmen hızlandırmak.
Bölünmüş yüklemenin ne kadar yavaşlattığını biz ölçmedik. Önerilen ayarlarla yaptığımız benchmark’ta Gemma 4 ve Qwen3.6 tamamen kartta çalıştı; bölünmüş yüklemeyi ölçmediğimiz için “taşarsa yavaşlar” yargısını yalnız dokümana dayandırıyoruz. Bağlam uzunluğu da belleği etkiler: Ollama’nın varsayılan bağlamı 4096 token ve OLLAMA_CONTEXT_LENGTH ile değişiyor. Uzun belgelerde bağlamı büyütmeniz gerekir ve bellek ihtiyacı o ölçüde artar.
24 GB’lık tek RTX 3090 ne kadar iş görür?
#NVIDIA, RTX 3090’ın belleğini 24 GB GDDR6X olarak yayımlıyor. Bu kartta iki modeli aynı altı görevle ölçtük: qwen3.5:9b ve gemma4:26b, Gemma’yı MTP kapalı ve açık olmak üzere iki kez. Üç koşuda da düşünme kapalıydı, bağlam penceresi 65.536 token’dı, kuantizasyon Q4_K_M’di ve Ollama 0.40.6 kullanıldı. Süreler model yüklemesi hariçtir ve altı görevin toplamıdır.
| Model | Ollama dosyası | Kart belleği | Yazma hızı | Altı görevin süresi |
|---|---|---|---|---|
| qwen3.5:9b | 6,6 GB | 9,7–10,0 GB | 100,7 token/sn | 2 dk 21,2 sn |
| gemma4:26b, MTP kapalı | 18 GB | 20,5–21,4 GB | 104,1 token/sn | 1 dk 42,8 sn |
| gemma4:26b, MTP açık | 18 GB (+0,46 GB taslak) | 20,9–21,4 GB | 219,4 token/sn | 1 dk 3,7 sn |
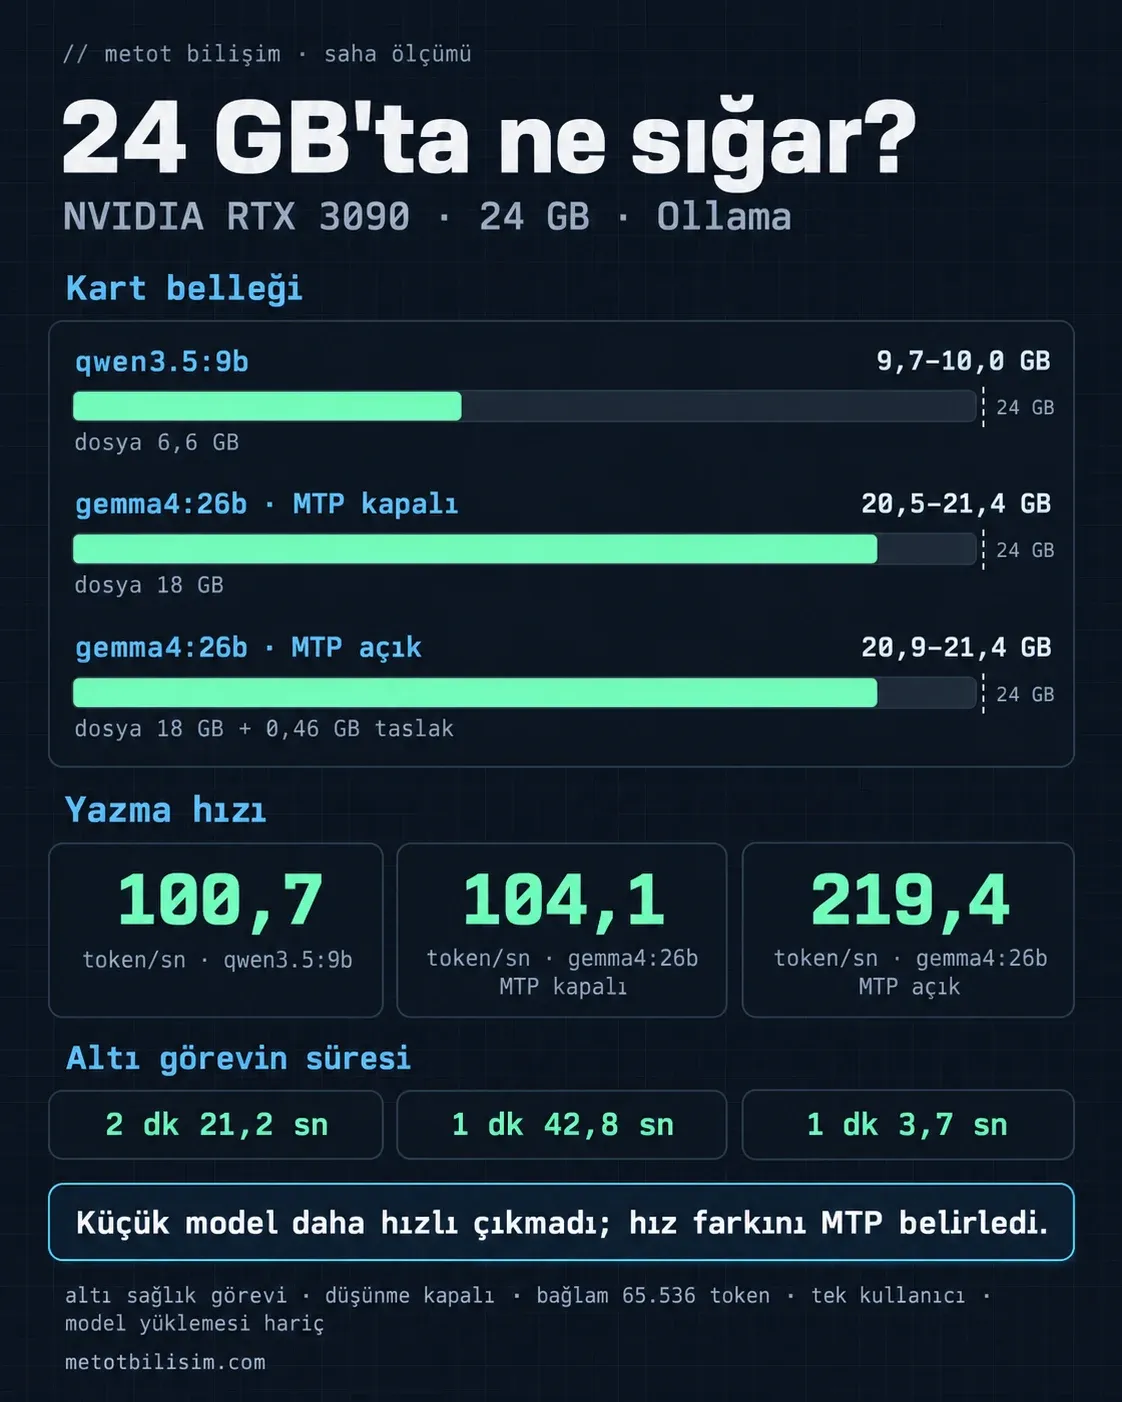
Görevler bir sağlık kuruluşunun gündelik işlerini taklit ediyor; belgelerin hepsi kurguydu. Her görev ve mod için tek çağrı koştuk, yani sonuçlar kesin bir sıralama değil, ilk ölçümdür. Testin tamamı Küçük Model Hızlı mı? Qwen3.5 ve Gemma 4 yazısında.
Kaç GB VRAM gerekir?
#Tek bir rakam yok; model dosyasına bağlam ve çalışma alanı eklenir. Bizim ölçümümüzde dosya boyutunun üstüne 65.536 token’lık bağlam ve çalışma alanı yaklaşık 3 GB bindi. Qwen’in yanında kartta yaklaşık 14 GB, Gemma’nın yanında yaklaşık 3 GB boş yer kaldı. Boş yerin neye yeteceğini denemedik.
24 GB’lık kartta iki model: biri yarısından azını, öteki neredeyse tamamını doldurdu
Ekran kartı belleği (GB). Dosya boyutu Ollama’nın model listesinden, kullanım nvidia-smi’den. Bağlam 65.536 token.
- qwen3.5:9b
- gemma4:26b MTP açık
- referans: kartın kapasitesi (24 GB)
Ollama dosyası
Çalışırken en düşük
Çalışırken en yüksek
Tablo olarak göster
| Ölçüm | qwen3.5:9b | gemma4:26b MTP açık |
|---|---|---|
| Ollama dosyası | 6,6 | 18 |
| Çalışırken en düşük | 9,7 | 20,9 |
| Çalışırken en yüksek | 10,0 | 21,4 |
Başka testlerimizde de aynı sonucu gördük. Hukuk bürosu testinde Gemma 4 kartın tamamında en çok yaklaşık 20,7 GB kullandı; sağlık kuruluşu testinde bu değer yaklaşık 21,4 GB’tı. Önerilen ayarlarla yaptığımız benchmark çalışmasında Unsloth’un sıkıştırılmış Qwen3.6-35B-A3B paketi (Ollama’da 18 GB) ön kontrolde kartta yaklaşık 20,4 GB tuttu. Bu üç değer farklı testlerin kendi koşullarındaki ölçümleridir; yukarıdaki tabloyla aynı koşuldaymış gibi okumayın. 24 GB’tan küçük kartları hiçbirinde denemedik.
Bağlam penceresini büyütmek belleği nasıl etkiler?
#Bağlam penceresi büyüdükçe model aynı anda daha çok metin görür, ama kartta daha çok yer tutar. Ölçümlerimizde 65.536 token’lık bağlam, model dosyasının üstüne yaklaşık 3 GB ekledi; iki modelde de ek benzerdi. Ollama’nın varsayılan 4096 token’ı kısa sohbetler için yeterli olabilir. Birkaç belgeyi birlikte okutacaksanız bağlamı büyütmeniz gerekir ve kart belleğini buna göre hesaplamalısınız.
Bu nedenle “modelim kartıma sığıyor” demek yetmez. Model dosyası sığsa da bağlam eklenince kart dolabilir. Gemma’da bunu gördük: 18 GB’lık dosya, bağlamla birlikte 24 GB’lık kartın yaklaşık 21 GB’ını kullandı ve yanında yaklaşık 3 GB boşluk kaldı. Bağlamı daha da büyütmeyi denemedik.
Küçük model her zaman daha hızlı mı?
#Hayır. MTP kapalıyken 9 milyar parametreli qwen3.5:9b ile 25,2 milyar parametreli gemma4:26b aynı hızda yazdı: 100,7’ye karşı 104,1 token/sn. Gemma altı görevde daha az token yazdığı için işi erken bitirdi; Qwen 11.268, Gemma 7.973 token yazdı. Qwen’in kazancı bellekteydi.
Bu yüzden donanım seçerken “büyük model yavaş, küçük model hızlı” varsayımı işe yaramıyor. Kartı model dosyasının boyutuna göre değil, çalıştıracağınız işte ölçülen belleğe ve süreye göre seçin.
Kaç kullanıcı için ne gerekir?
#Eş zamanlı kullanıcı sayısı bellek ihtiyacını artırır, ama biz bunu ölçmedik; tüm ölçümlerimiz tek kullanıcılı. Aşağıdakiler resmî dokümandaki bilgilerdir, testimizin sonucu değildir.
Ollama dokümanına göre OLLAMA_NUM_PARALLEL, bir modelin aynı anda işleyebileceği istek sayısını belirler; varsayılanı 1’dir. Gereken bellek OLLAMA_NUM_PARALLEL ile OLLAMA_CONTEXT_LENGTH çarpımıyla büyür. Doküman bir örnek veriyor: 2K bağlam ve 4 paralel istek, 8K bağlam kadar bellek ister. Yani kullanıcı sayısını artırmak, bağlamı büyütmekle benzer biçimde kartı doldurur.
| Ayar | Ne yapar | Varsayılan |
|---|---|---|
OLLAMA_NUM_PARALLEL |
Bir modelin aynı anda işlediği istek sayısı | 1 |
OLLAMA_CONTEXT_LENGTH |
Sunucu genelinde bağlam uzunluğu | 4096 token |
OLLAMA_MAX_QUEUE |
Meşgulken kuyrukta bekleyen en çok istek | 512 |
Kuyruk dolarsa Ollama 503 hatası döndürür. Çok kullanıcılı üretim ortamı için vLLM dokümanı, gelen istekleri sürekli gruplayarak (continuous batching) ve dikkat belleğini PagedAttention ile yöneterek yüksek verim hedeflediğini anlatıyor. Bu araçların sizin kartınızda kaç kullanıcıya yettiği, ancak kendi modelinizle ve belgelerinizle yapılacak bir ölçümle görülür.
İş istasyonu mu, rack sunucu mu, GPU kiralama mı?
#Üç seçenek arasındaki asıl fark verinin nerede durduğu ve bakımı kimin yaptığıdır. Tablo, yalnız karşılaştırma ölçütlerini veriyor; rakam içermiyor.
| Ölçüt | İş istasyonu | Rack sunucu | GPU kiralama |
|---|---|---|---|
| Veri konumu | Kurumunuzda | Kurumunuzda ya da kendi veri merkezinizde | Sağlayıcının sunucusunda |
| Başlangıç yatırımı | Donanım alımı gerekir | Donanım alımı gerekir | Donanım alımı yok, düzenli kira var |
| Ölçekleme | Makine eklenerek | Kart ve makine eklenerek | Sağlayıcının sunduğu kadar |
| Bakım | Sizde | Sizde | Sağlayıcıyla paylaşırsınız |
| Gürültü ve soğutma | Ofis ortamında düşünülmeli | Sunucu odası gerekir | Sizi ilgilendirmez |
| KVKK etkisi | Aktarım adımı oluşmayabilir | Aktarım adımı oluşmayabilir | Sözleşme ve aktarım koşulları gerekir |
Seçimi şu soru yönlendirir: verinin nerede işleneceğine siz mi karar vermek istiyorsunuz, yoksa bu kararı sağlayıcıyla yazılı sözleşmeye mi bağlayacaksınız? Kendi makinenizde de verinin kurum dışına çıkmaması, yalnız sunucunun yerine bağlı değildir. Dış yedekleme, destek bağlantısı ve belge okuma servisleri bu durumu değiştirebilir. Yerel kurulum KVKK yükümlülüklerinizi de ortadan kaldırmaz; hukuki sebep, aydınlatma ve erişim güvenliği sürer.
Mevcut sunucunuz yeterli mi?
#Mevcut sunucu yeterli olabilir; karar, hedef iş yükünün incelenmesiyle verilir. Aşağıdaki maddelerden herhangi birinde belirsizlik varsa, yeni donanım almadan önce o noktayı netleştirin:
- Ekran kartı var mı ve belleği (VRAM) çalıştıracağınız modele ile bağlama yetiyor mu?
- Sistem belleği, belge okuma ve arama katmanını da taşıyabiliyor mu?
- Diskte model dosyaları için yer var mı? Bizim paketlerimiz 6,6 ve 18 GB’tı.
- Güç kaynağı ve soğutma, kartın teknik özelliklerindeki gereksinimi karşılıyor mu?
- Sürücü ve CUDA sürümü, kullanacağınız araçla uyumlu mu?
- Ağ, kullanıcıların aynı anda erişmesine yetiyor mu?
Bu kontrol, kuruluma geçmeden önce yapılan bir ön değerlendirmedir. Sonucu “kart var, o hâlde yeter” diye okumayın: aynı kart küçük bir modelle rahat çalışır, büyük bir model ve uzun bağlamla kapasitesinin sınırına dayanır. Önce hedef işi, modeli ve bağlam uzunluğunu belirleyin; ardından mevcut makineyi bu üçüyle karşılaştırın.
Donanım dışında hangi maliyet kalemleri vardır?
#Donanımın yanında enerji, soğutma, yedekleme, bakım, lisans koşulları ve genişleme maliyeti hesaba girer. Bu kalemlerin tutarı kuruma göre değiştiği için burada rakam vermiyoruz. Kullanıcı sayısı veya belge havuzu büyürse kart, bellek ve depolama eklemek gerekebilir; genişleme yolunu baştan düşünmek, ikinci bir donanım kararının maliyetini görünür kılar.
Hangi kalemin ne kadar yer tutacağını önceden bilmek zordur; çünkü kullanıcı sayısı, bağlam uzunluğu ve belge hacmi pilotta netleşir. Teklifi pilotta görülen iş yüküne ve kabul ölçütlerine göre hazırlamak daha sağlıklı bir zemin sağlar. Böylece kararı modelin adı ya da sunucunun elde var olması değil, kendi belgelerinizle ölçülen sonuç belirler. Yerel yapay zekâ kurulumunda mevcut sunucunuza, yeni donanım önermeden önce bakarız.
Kaynaklar
#yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinYapay zekâ çalıştırmak için hangi sunucu alınmalı?
Önce çalıştıracağınız modele ve bağlam uzunluğuna bakın; sunucuyu bunlar belirler. Modelin ve bağlamın sığacağı ekran kartı belleği (VRAM) ilk ölçüttür; işlemci, sistem belleği ve disk ikinci planda kalır. Bizim testimizde 24 GB'lık tek RTX 3090, 9 ve 25,2 milyar parametreli iki modeli 65.536 token'lık bağlamla çalıştırdı; Gemma kartın yaklaşık 21 GB'ını kullandı. Kullanıcı sayısı ve belge hacmi büyüyorsa, donanım kararını kendi iş yükünüzle yapılan bir pilotun sonuçlarına göre verin.
Lokal yapay zekâ için kaç GB VRAM gerekir?
Tek bir sayı yok; model dosyası, bağlam penceresi ve aynı anda işlenen istek sayısı toplanır. Testimizde 6,6 GB'lık qwen3.5:9b kartta 9,7–10,0 GB, 18 GB'lık gemma4:26b 20,5–21,4 GB tuttu; ikisinde de bağlam 65.536 token'dı ve bağlam yaklaşık 3 GB ekledi. Daha küçük kartları denemedik, o yüzden 24 GB altı için ölçüm vermiyoruz.
RTX 3090 lokal yapay zekâ için yeterli mi?
Denediğimiz işlerde yetti. NVIDIA kartın belleğini 24 GB GDDR6X olarak veriyor. Bu kartta Gemma 4 26B ile hukuk ve sağlık görevlerini, Qwen3.5 9B ile sağlık görevlerini tek kullanıcıyla çalıştırdık; kartın belleği en çok yaklaşık 21,4 GB doldu. Aynı anda birden çok kullanıcıyı ve daha büyük modelleri bu kartta ölçmedik.
Lokal yapay zekâ ekran kartı olmadan, yalnız işlemciyle çalışır mı?
Çalışabilir. Ollama modeli yalnız sistem belleğinde de yükleyebiliyor; `ollama ps` çıktısında bu durum '100% CPU' diye görünür. llama.cpp da CPU ve GPU karma çalışmayı destekliyor. İşlemciyle hızı ölçmedik; kullanıcıya yanıt veren bir sunucu için hızı kendi modelinizle denemeden karar vermeyin.
GPU kiralamak mı satın almak mı daha mantıklı?
Veri konumu ve iş yükünün sürekliliği belirler. Kiralık GPU'da model ve belgeler sağlayıcının sunucusunda çalışır; sözleşme, erişim ve veri aktarımı koşullarını yazılı netleştirmeniz gerekir. Kendi makinenizde veri kurumunuzda kalır, ama donanım, bakım ve soğutma sizin sorumluluğunuzdadır. Maliyet karşılaştırmasını pilotta görülen iş yüküyle yapın; biz bu yazıda fiyat vermiyoruz.
MTP nedir, donanım seçimini etkiler mi?
MTP, küçük bir taslak modelin önerdiği token'ları ana modelin tek adımda doğruladığı bir hızlandırma yöntemidir. Ollama'nın gemma4:26b paketinde 0,46 GB'lık taslak model var. Aynı kartta MTP kapalıyken 104,1, açıkken 219,4 token/sn yazdı. Yani aynı donanımdan alınan hız, yazılım ayarına ve çıktı türüne bağlı; kart seçerken yalnız model boyutuna bakmayın. Başka bir kartta kazanç farklı olabilir.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen lokal (yerel) yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
- yazılım
Özel Yazılım ve Web Uygulaması Geliştirme
Web uygulaması, özel işlev ve entegrasyon ihtiyaçlarınızı birlikte değerlendirelim.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
- yerel yapay zekâ
11 dk okuma
Gemma 4 ve LFM2.5: Önerilen Ayarlarla Karşılaştırmalı Benchmark
Gemma 4 26B ile LFM2.5 24B'yi aynı RTX 3090'da, üreticilerinin önerdiği ayarlarla karşılaştırdık. Gemma verilen kurallara uyma, kod yazma ve küçük projedeki hataları düzeltmede daha çok işi tamamladı. Büyük belgede Gemma cevap yazamadı; LFM2.5 cevap verdi ama on sorudan yalnızca birini bildi.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.