11 dk okuma
Gemma 4 ve LFM2.5: Önerilen Ayarlarla Karşılaştırmalı Benchmark
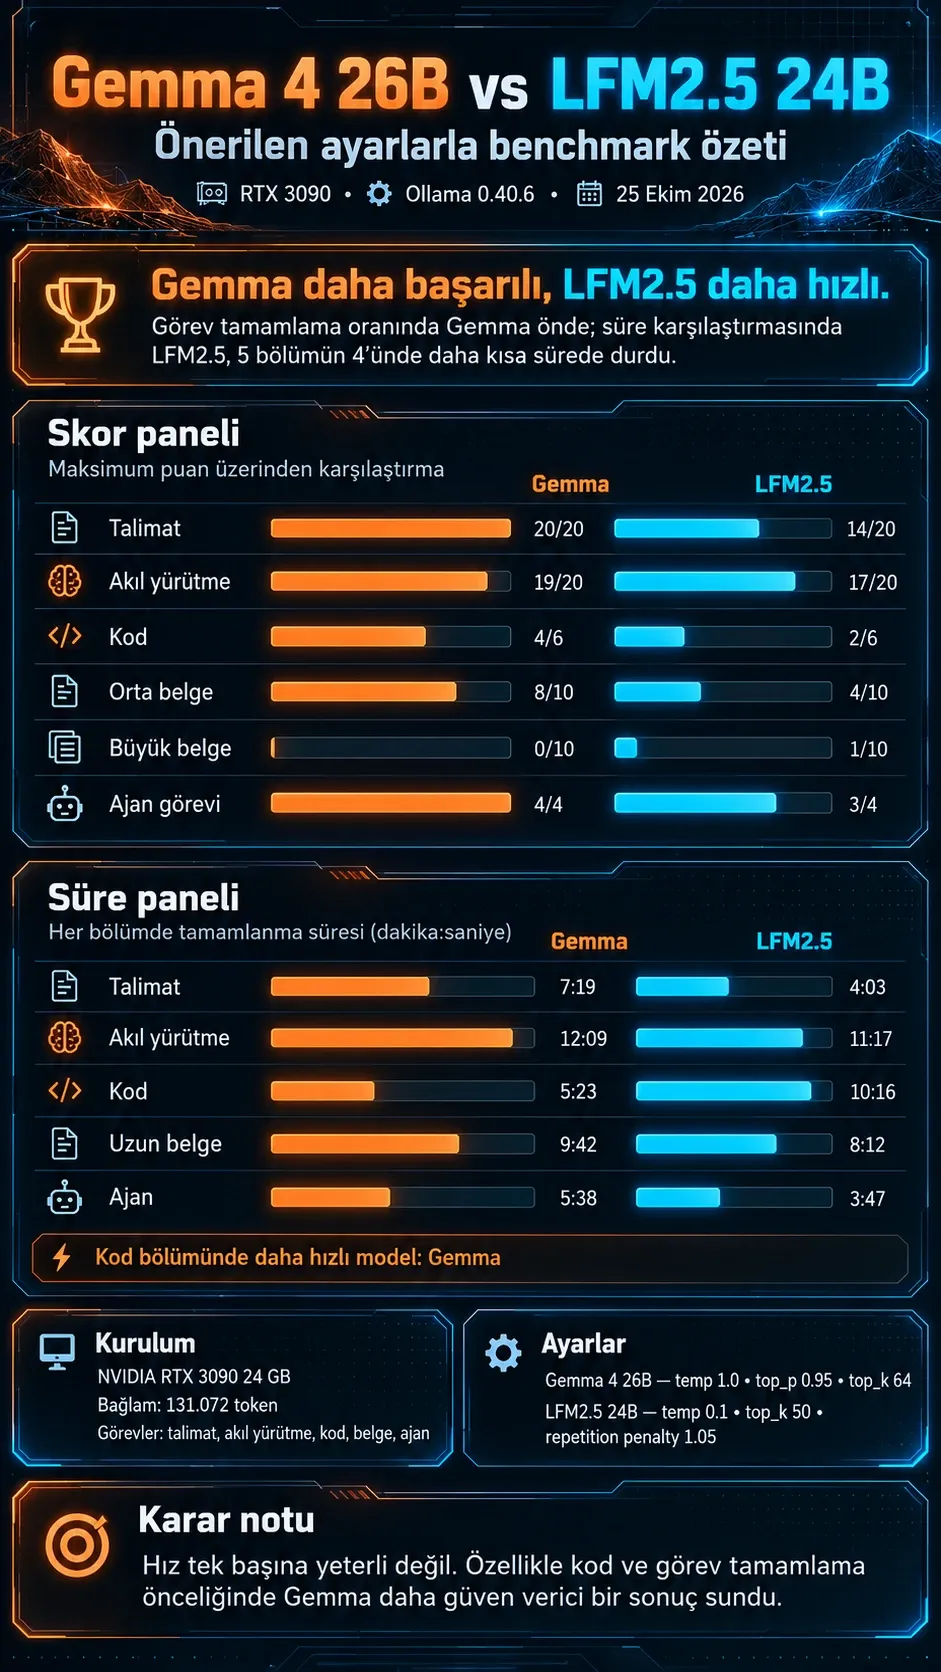
Gemma 4 26B ile LFM2.5 24B'yi aynı RTX 3090'da, üreticilerinin önerdiği ayarlarla karşılaştırdık. Gemma verilen kurallara uyma, kod yazma ve küçük projedeki hataları düzeltmede daha çok işi tamamladı. Büyük belgede Gemma cevap yazamadı; LFM2.5 cevap verdi ama on sorudan yalnızca birini bildi.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- Gemma 60 kuralın tamamına, LFM2.5 52'sine uydu. Akıl yürütmede sonuç 19/20 ve 17/20 oldu.
- Altı kod görevinin dördünü Gemma, ikisini LFM2.5 eksiksiz çözdü. Küçük projedeki dört hatayı Gemma düzeltti; LFM2.5 üçünde başarılı oldu.
- Orta boy belgede Gemma 8/10, LFM2.5 4/10 aldı. Büyük belgede Gemma cevap yazamadı; LFM2.5 1/10 aldı.
Gemma 4 ve LFM2.5 hangi işlerde ayrıldı?
#Gemma verilen kurallara uymada, akıl yürütmede, kodda ve orta boy belgede daha yüksek puan aldı; küçük projedeki dört hatayı da düzeltti. LFM2.5 büyük belgede cevap yazabildi, Gemma yazamadı. Ancak LFM2.5’in bu belgedeki on cevabından yalnızca biri doğruydu.
İki modeli 25 Ekim 2026’da aynı bilgisayarda, kendi üreticilerinin önerdiği ayarlarla çalıştırdık. İşlerin tamamlanıp tamamlanmadığına, cevapların puanına ve bitirme sürelerine baktık.
Talimat: eksiksiz geçilen istem
Gemma 4 26B20/20LFM2.5 24B14/20Akıl yürütme: doğru cevap
Gemma 4 26B19/20LFM2.5 24B17/20Kod: eksiksiz çözülen görev
Gemma 4 26B4/6LFM2.5 24B2/6Orta belge: tam doğru cevap
Gemma 4 26B8/10LFM2.5 24B4/10Büyük belge: tam doğru cevap
Gemma 4 26B0/10, cevap yokLFM2.5 24B1/10Küçük proje: düzeltilen hata
Gemma 4 26B4/4LFM2.5 24B3/4
Bu, Gemma 4 vs LFM2.5: Yerel Yapay Zekâ Testi yazısındaki karşılaştırmadan ayrı bir test. Önceki çalışmada iki model aynı ayarlardaydı; burada üreticilerin önerilerini kullandık. Kurulumları farklı olduğu için iki testin sayılarını yan yana koymuyoruz.
Aynı senaryonun Qwen karşılaştırması Gemma 4 ve Qwen3.6: Önerilen Ayarlarla Benchmark yazısında. Oradaki Gemma sonuçları bu koşudan alındı; Gemma yeniden çalıştırılmadı.
Testi hangi kurulumla yaptık?
#24 GB bellekli tek NVIDIA RTX 3090 ve Ollama 0.40.6 kullandık. Ollama, modelleri kendi bilgisayarınızda çalıştırmanızı sağlayan bir programdır.
Gemma’nın paketi gemma4:26b idi. LFM2.5’i Ollama’da richardyoung/lfm2.5-24b-a2b:latest topluluk paketiyle çalıştırdık; ayarlarını Liquid AI’ın model kartından aldık.
Token, modelin metni işlerken kullandığı, bir kelimenin tamamı veya bir kısmı olabilen küçük parçadır. Bağlam penceresi, modelin girdi, düşünme ve cevap için bir seferde kullanabildiği toplam alandır. İki modelde de bu alanı 131.072 token olarak ayarladık.
- Ön kontrolde iki model de bu bağlamla tamamen ekran kartında çalıştı.
- Görev başına çıktı, süre veya adım sınırı koymadık.
- Bağlam dolunca eski metni silerek devam etme ve sığmayan istemi kırpma özelliklerini kapattık.
- İki modelde de cevap öncesi düşünme açıktı; LFM2.5’te bu özellik kapatılamıyor.
Tekrar döngüsüne girme veya beş dakika veri üretmeme durumları için durdurma kuralları vardı. Proje görevinde tekrarlanan, araçsız veya bozuk işlemler için ek kontroller kullandık. Hiçbiri devreye girmedi; bütün koşu yaklaşık 1 saat 26 dakika sürdü.
Önerilen ayarlar nelerdi?
#Gemma için Google’ın, LFM2.5 için Liquid AI’ın model kartındaki örnekleme değerlerini kullandık. Sıcaklık, modelin cevap üretirken yaptığı seçimlerin ne kadar değişken olacağını belirler. top_p ve top_k, modelin sıradaki metin parçası için değerlendirdiği seçenekleri olasılığa ve sayıya göre sınırlar. Tekrar cezası, modelin aynı ifadeleri yeniden seçmesini zorlaştıran ayardır.
| Ayar | Gemma 4 | LFM2.5 |
|---|---|---|
| Sıcaklık | 1,0 | 0,1 |
| top_p | 0,95 | kartta belirtilmemiş |
| top_k | 64 | 50 |
| Tekrar cezası | kartta belirtilmemiş | 1,05 |
Bu değerlerin dışında ek örnekleme ayarı göndermedik. Ollama paketlerinin taşıdığı değerleri de model kartlarıyla karşılaştırdık; aynıydılar.
Beş bölümde neyi ölçtük?
#Kurallara uyma, iş hesabı, kod doğruluğu, belgeden cevap bulma ve proje düzeltme becerilerini ölçtük. Gizli test, modelin çözüm üretirken görmediği ve tesliminden sonra kodunu sınamak için kullanılan kontroldür. Ajan, dosya okuma, düzenleme ve test çalıştırma gibi araçlarla bir işi adım adım yürüten modeldir.
| Bölüm | Verilen iş | Başarı ölçüsü |
|---|---|---|
| Talimat | Her birinde üç kural olan 20 iş istemi | Bütün kuralları geçen istem |
| Akıl yürütme | İş hesabı, takvim, sıralama, tablo ve yetersiz bilgi soruları | Doğru yanıtlanan soru sayısı |
| Kod | C#, JavaScript ve PHP’de ikişer görev | Bütün gizli testleri geçen çözüm |
| Uzun belge | Yaklaşık 93 bin ve 254 bin karakterlik iki şirket arşivi | Her belgede 10 soruya tam doğru cevap |
| Ajan | Dört hata içeren küçük bir Node.js projesi | Özgün görünür testleri ve gizli testleri geçmek |
Talimat ve akıl yürütme Türkçeydi; kod, uzun belge ve ajan görevleri İngilizceydi. Arşivler gerçek müşteri verisinden değil, test için hazırlanmış şirket kayıtlarından oluşuyordu.
Talimatlara hangi model daha iyi uydu?
#Gemma 60 kuralın tamamına, LFM2.5 52’sine uydu. Gemma 20 istemin hepsini, LFM2.5 14’ünü eksiksiz geçti.
LFM2.5 yasak kelime kuralını beş istemin hepsinde çiğnedi
Her kural türünde uyulan kuralların oranı; parantezler o türdeki kural sayısını belirtir.
- Gemma 4
- LFM2.5
Yasak kelime5
JSON alan adları2
Kaynaktaki seçilmiş bilginin cevapta bulunması20
Diğer biçim kuralları33
Tablo olarak göster
| Kural türü | Gemma 4 | LFM2.5 |
|---|---|---|
| Yasak kelime (5) | %100 | %0 |
| JSON alan adları (2) | %100 | %50 |
| Kaynaktaki seçilmiş bilginin cevapta bulunması (20) | %100 | %90 |
| Diğer biçim kuralları (33) | %100 | %100 |
LFM2.5 yasaklanan kelimeleri kullandı: iki istemde “özür”, birinde “ucuz”, “indirim” ve “fiyat”, birinde “sorun” ve “bakım”, iş ilanında “genç”, “bayan” ve “dinamik”. Bir JSON yanıtında, yani alan adlarıyla düzenlenmiş veri çıktısında, istenen urun yerine ürün yazdı. Bu yanıt seçilmiş bilgi kontrolünü de geçemedi; başka bir istemde kaynakta verilen dönüş süresini atladı.
Kelime, cümle, madde ve paragraf sayısı gibi diğer 33 biçim kuralını iki model de geçti. Gemma tam puan aldığı için bu görevler onun talimat takibindeki sınırını göstermedi.
Talimat puanı içerik doğruluğunu ölçmüyor. Seçilmiş sayı, tarih ve adların cevapta bulunmasını kontrol ettik; doğru bağlamda kullanılıp kullanılmadıklarını veya metnin niteliğini puanlamadık.
Akıl yürütmedeki fark nereden geldi?
#Gemma 20 sorudan 19’unu, LFM2.5 17’sini geçti; LFM2.5’in kayıplarından biri hesap değil, cevap biçimi hatasıydı. İki modelin de kaçırdığı soru ise çağrılma sırasını bulmayı gerektiriyordu.
Puan farkı iş hesabı ve tablo sorularında oluştu
Her soru türünde dört soru vardı.
- Gemma 4
- LFM2.5
İş hesabı
Takvim
Kurallara göre sıralama
Tablo okuma
Bilginin yetersiz olduğu sorular
Tablo olarak göster
| Soru türü | Gemma 4 | LFM2.5 |
|---|---|---|
| İş hesabı | 4/4 | 3/4 |
| Takvim | 4/4 | 4/4 |
| Kurallara göre sıralama | 4/4 | 4/4 |
| Tablo okuma | 4/4 | 3/4 |
| Bilginin yetersiz olduğu sorular | 3/4 | 3/4 |
Yanlış sayılan cevapları ayrı ayrı inceledik. Üçünde de puanı koruduk; ortak yanlışta sorunun ifadesinden kaynaklanan belirsizliği ayrıca belirttik.
İki modelin de kaçırdığı sıralama sorusu
Altı kişinin çağrılma sırasına ilişkin “Ayşe, Kaan ile Burak arasında çağrılıyor” cümlesini iki model de “üçü art arda” diye yorumladı. Oysa cümle art arda gelmeyi şart koşmuyordu. Kurallara uyan beş sıralama vardı; altıncı kişi Oya da Kaan da olabiliyordu.
Beklenen cevap “belirlenemez” olduğu için iki modelin tek isim veren cevabı yanlış sayıldı. Soruyu biz yazdık; ifadenin iki türlü anlaşılabildiğini kabul ediyoruz.
LFM2.5’in yuvarlama hatası
Bir iş hesabında kalemleri ayrı ayrı yuvarlayıp topladı. Doğru sonuç 22.149,61 iken 22.150,00 buldu.
LFM2.5’in doğru cevaba rağmen puan kaybetmesi
Bir tablo sorusunda doğru cevabı buldu ama istenen CEVAP: satırını ayrı son satır olarak yazmadı. Bu yüzden cevap biçim hatası sayıldı.
Akıl yürütme puanındaki iki soruluk farkın biri sayısal sonuçtan, diğeri teslim biçiminden geliyor. İkisini de yanlış hesap yapılmış gibi okumamak gerekiyor.
Kod görevlerini hangi model eksiksiz çözdü?
#Gemma altı görevin dördünde, LFM2.5 ikisinde bütün testleri geçti. Bir çözümün başarılı sayılması için çalışması, beklenen testleri geçmesi ve sürecin hatasız bitmesi gerekiyordu.
| Görev | Gemma 4 | LFM2.5 |
|---|---|---|
| C#: matematik ifadelerini hesaplama | 88/88 | 30/88 |
| C#: değişiklikleri geri alabilen veri deposu | 35/35 | 0/35, derlenmedi |
| JavaScript: hata alınca yeniden deneyen iş kuyruğu | 35/35 | 35/35 |
| JavaScript: yardımcı işlevlerde hata düzeltme | 66/70 | 55/70 |
| PHP: Roma rakamları çevirici | 93/93 | 93/93 |
| PHP: süreli ve kullanım sıralı önbellek | 34/47 | 0/47, çalışmadı |
İki model de iş kuyruğunu ve Roma rakamları görevini eksiksiz çözdü. Gemma’nın iki C# çözümü de tam puan aldı; LFM2.5’in C# çözümleri farklı nedenlerle başarısız oldu.
- LFM2.5’in hesap makinesi: Kapanış parantezini yanlış tanıyor, sayıları hesaplama aşamasına aktaramıyordu.
1+2bile çalışmadı; geçen 30 test, hatalı girdiyi reddetme kontrolleriydi. - LFM2.5’in veri deposu: Yanlış yerde kullanılan noktalı virgül yüzünden kod derlenmedi. Diğer mantık hataları puanı değiştirmedi; çözüm zaten çalışamıyordu.
- LFM2.5’in PHP önbelleği: PHP’nin desteklemediği biçimde bir sınıfın içine başka sınıf yazdı. Dosya yüklenemedi; 47 test çalışamadan başarısız sayıldı.
- Gemma’nın JavaScript düzeltmesi: Özel bir alan adını (
__proto__) koruyamadı ve listelerin uzunluğunu karşılaştırmadı. Bu davranışlar istemde açıkça yazıyordu. - LFM2.5’in JavaScript düzeltmesi: Adres metnindeki
+işaretini boşluğa çevirmedi; özel alan adlarında, karşılaştırmalarda ve zamanlanmış çağrıları yönetmede hatalar bıraktı. - Gemma’nın PHP önbelleği: Kayıt listesini yanlış yönde dolaştığı için yalnızca tek anahtar döndürdü. Aynı hata 13 testin kaybına yol açtı.
On iki çözümün tamamı elle incelendi. Test düzeneğine müdahale, istemde bulunmayan beklenti veya puanlayıcı hatası saptanmadı; puanlar değişmedi. Kodlar geçici klasörde çalıştırıldı; işletim sistemi düzeyinde güvenlik yalıtımı kullanılmadı.
Ana puana katılmayan ölçeklenme kontrollerinde Gemma 2/2, LFM2.5 0/2 aldı; LFM2.5’in ilgili çözümleri çalışmıyordu. Bu kontroller geçen süreye dayanıyordu. Görevlerin test sayıları farklı olduğundan geçen testleri toplayarak model puanı üretmedik.
Uzun belgede cevap vermek yeterli oldu mu?
#Hayır; büyük belgede LFM2.5 cevabını tamamladı ama on sorudan yalnızca birini doğru yanıtladı. Gemma ise cevap yazamadan bağlam sınırına ulaştı. Orta boy belgede Gemma 8/10, LFM2.5 4/10 aldı.
Büyük belgede Gemma cevapsız kaldı, LFM2.5 bir doğru cevap verdi
Her belgede on soruya verilen tam doğru cevap sayısı.
- Gemma 4
- LFM2.5
Orta boy, yaklaşık 93 bin karakter
Büyük, yaklaşık 254 bin karakter
Tablo olarak göster
| Belge | Gemma 4 | LFM2.5 |
|---|---|---|
| Orta boy, yaklaşık 93 bin karakter | 8/10 | 4/10 |
| Büyük, yaklaşık 254 bin karakter | 0/10, cevap yok | 1/10 |
Aynı metin, modellerin metni farklı parçalara ayırması nedeniyle farklı sayıda token tuttu. Büyük belgeden sonra Gemma’nın düşünme ve cevap için 47.053 token alanı kalmıştı.
| Belge | Girdinin tuttuğu token: Gemma / LFM2.5 | Düşünme ve cevaba kalan: Gemma / LFM2.5 |
|---|---|---|
| Orta boy | 31.787 / 26.612 | 99.285 / 104.460 |
| Büyük | 84.019 / 70.650 | 47.053 / 60.422 |
Gemma büyük arşivdeki kayıtları tek tek sayarak düşünmeye devam etti. İlerleyen bu sayım bir tekrar döngüsü değildi; cevap aşamasına geçemeden toplam 131.072 token sınırına ulaştı. Eski metni silerek devam etme kapalıydı; sonuç cevap yok olarak kaydedildi ve 0/10 aldı.
Büyük arşivde hem metin hem de arama ve hesap yükü arttı. İki belge arasındaki puan düşüşünü yalnızca metin uzunluğuna bağlayamıyoruz.
Ajan görevini hangi model bitirdi?
#Gemma dört hatayı da düzeltti ve 26 gizli testin tamamını geçti. LFM2.5 üç hatayı düzeltti; para paylaştırma işlevindeki hata kaldı.
| Ölçüt | Gemma 4 | LFM2.5 |
|---|---|---|
| Gizli testler | 26/26 | 22/26 |
| Özgün görünür testler | 4/4 | 4/4 |
| Adım sayısı | 25 | 19 |
| Süre | 5 dk 38 sn | 3 dk 47 sn |
İki model de işin bittiğini bildirdi ve görünür testleri geçti. LFM2.5’in kalan kuruşları dağıtan döngüsü ise erken bitiyor ve aynı satırı tekrar seçiyordu. Bu işlevin dokuz gizli testinden dördü geçmedi; beklenen davranış proje belgesinde örneklerle açıklanmıştı.
Gemma çalışırken görünür test dosyasını değiştirdi. Puanlamadan önce özgün dosya geri kondu; değişiklik puanı etkilemedi. LFM2.5 görünür testlere dokunmadı.
Hangi model daha kısa sürede bitirdi?
#LFM2.5 beş bölümün dördünde daha kısa sürede durdu; kod bölümünü Gemma daha kısa sürede bitirdi. Süreleri, teslim edilen işin puanıyla birlikte değerlendirdik.
Gemma, Ollama paketindeki MTP taslak modeli açık çalıştı. MTP, küçük bir modelin sıradaki parçaları tahmin ettiği ve ana modelin bu tahminleri birlikte kontrol ederek üretimi hızlandırdığı yöntemdir. Gemma’nın saniyede 200 token’ı aşan hızı bu hızlandırmadan ve JSON, kod gibi kalıplı çıktıdan geliyor. MTP kapalıyken aynı model bu kartta saniyede 104–109 token yazıyor; LFM2.5 paketinde taslak model yok. Bu nedenle token/sn kıyası yapmıyoruz; ayrıntılar Lokal AI Modellerde MTP Nedir ve Çıktı Türü Hızı Etkiler mi? yazısında.
LFM2.5 dört bölümde daha kısa süre harcadı; kodda Gemma daha hızlıydı
Süreler en yakın saniyeye yuvarlandı; uzun belge süresi iki belgenin toplamıdır.
- Gemma 4
- LFM2.5
Talimat
Akıl yürütme
Kod
Uzun belge
Ajan
Tablo olarak göster
| Bölüm | Gemma 4 | LFM2.5 |
|---|---|---|
| Talimat | 7 dk 19 sn | 4 dk 3 sn |
| Akıl yürütme | 12 dk 9 sn | 11 dk 17 sn |
| Kod | 5 dk 23 sn | 10 dk 16 sn |
| Uzun belge | 9 dk 42 sn | 8 dk 12 sn |
| Ajan | 5 dk 38 sn | 3 dk 47 sn |
LFM2.5’in proje görevindeki kısa süresi, eksiksiz teslim anlamına gelmiyor: dört gizli test hâlâ başarısızdı. Kodda ise Gemma hem daha kısa sürede bitirdi hem de daha fazla görevi eksiksiz çözdü.
Sonuçlar birlikte nasıl okunmalı?
#Bu görevlerde Gemma daha fazla işi eksiksiz teslim etti; büyük belgede ise iki model de düşük puan aldı. Cevap yazabilmek, kurala uymak ve doğru sonuç üretmek ayrı ölçülerdi.
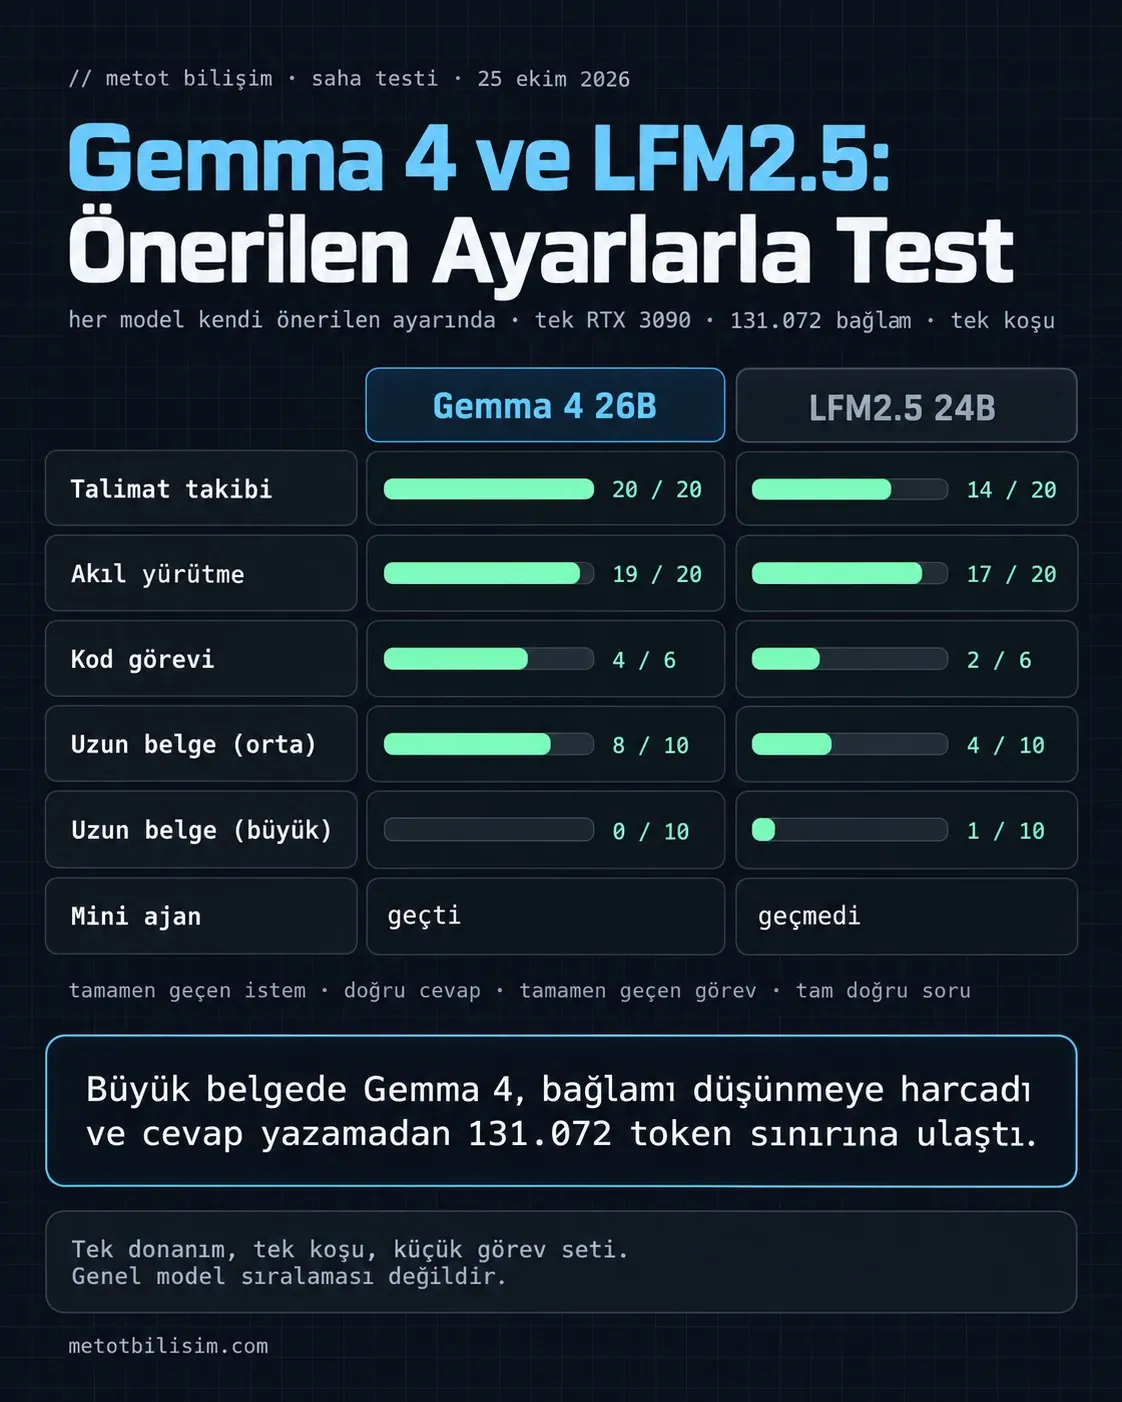
Talimat, akıl yürütme ve kodda LFM2.5’in geçip Gemma’nın kaçırdığı bir görev olmadı. İkisinin de geçemediği bir akıl yürütme sorusu ve iki kod görevi vardı.
Talimat:
LFM2.5’in en belirgin kaybı, kullanılmaması istenen kelimelerdi.
Akıl yürütme:
İki soruluk puan farkının biri cevap biçiminden kaynaklandı.
Kod:
Gemma dört, LFM2.5 iki görevi bütün testleri geçerek çözdü.
Belge:
Gemma orta boyda daha çok doğru cevap verdi, büyük belgede cevap yazamadı.
Proje:
Gemma bütün hataları düzeltti; LFM2.5’in para paylaştırma hatası kaldı.
Bu sonuçların kapsamı ne?
#Sonuçlar tek donanımda, her görevin bir kez çalıştırıldığı küçük ve elle hazırlanmış bir görev seti için geçerli. Bunlardan genel model sıralaması veya istatistiksel anlamlılık iddiası çıkarmıyoruz.
İşletmeniz için hangi ölçülere bakmalısınız?
#Doğruluğu, işin tamamlanmasını ve bekleme süresini birlikte ölçmelisiniz. Bu testte görünür kontrolleri geçmek ile bütün hataları düzeltmek, cevap yazmak ile doğru cevap vermek farklı sonuçlar doğurdu.
- Model, kullanmamasını istediğiniz kelimeleri gerçekten dışarıda bırakıyor mu?
- Belgenizden verdiği cevaplar doğrulanmış kayıtlarla uyuşuyor mu?
- Yazdığı kod çalışıyor ve sizin testlerinizi geçiyor mu?
- “Bitti” dediğinde işin kabul ölçütleri karşılanmış oluyor mu?
- Doğru sonuca ulaşma süresi iş akışınıza uyuyor mu?
Yerel yapay zekâ kurulumu için model seçimini belge erişimi ve kullanıcı yetkileriyle birlikte planlayın. Yapay zekâ danışmanlığı çalışmasında hangi işin hangi ölçütle kabul edileceğini belirleyin. Yazılım geliştirme aşamasında bu ölçütleri entegrasyon testlerine taşıyın.
Testi nasıl tekrarlayabilirsiniz?
#Depoyu indirip BASLAT.md dosyasındaki adımları izleyerek aynı görevleri kendi kurulumunuzda çalıştırabilirsiniz. Önce modeli çağırmadan düzeneği sınayan denemeyi, ardından ön kontrolü ve asıl testi başlatın.
// açık test verisi
- kod · MIT
- veri · CC BY 4.0
metotbilisim/gemma4-lfm25-onerilen-ayarlar-testi
github.com
Görevlerden ham cevaplara kadar testin kayıtları açık
İstemleri, puanlama kurallarını ve modellerin teslim ettiği çözümleri birlikte inceleyebilirsiniz.
// depoda neler var
Görevler:
Beş bölümün istemleri, soruları ve belgeleri.
Puanlama:
Puanlayıcılar ile kod ve ajan görevlerinin gizli testleri.
Çalıştırma dosyaları:
Programlar, ayarlar ve dosya özetlerini tutan manifest.
Ham cevaplar:
Modellerin yanıtları, düşünme metinleri ve çalıştırma kayıtları.
İnceleme:
Sonuç raporu ve on iki kod çözümünün elle inceleme notları.
git clone https://github.com/metotbilisim/gemma4-lfm25-onerilen-ayarlar-testi.gitBaşka bir modeli denerken gizli testleri çözüm üreten modele göstermeyin. Bu dosyalar teslimi denetlemek için kullanılıyor.
Kaynaklar ve doğrulama
#Puanlar otomatik sonuç raporuna, kod hatalarının açıklamaları elle inceleme kayıtlarına dayanıyor. Ayarların kaynakları üreticilerin model kartları; test kayıtları da depoda bulunuyor.
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinÜreticilerin hangi ayarlarını kullandınız?
Gemma için Google'ın, LFM2.5 için Liquid AI'ın model kartındaki değerleri kullandık. Bunların dışında ek örnekleme ayarı vermedik.
Hangi model verilen kurallara daha iyi uydu?
Gemma 20 istemdeki 60 kuralın tamamını geçti. LFM2.5 52 kuralı ve 14 istemi eksiksiz geçti; yasak kelime içeren beş istemin hepsinde kuralı çiğnedi.
Kod görevlerinde sonuç neydi?
Altı görevin dördünü Gemma, ikisini LFM2.5 bütün kontrolleri geçerek çözdü. LFM2.5'in bir C# çözümü derlenmedi, bir PHP çözümü çalışmadı.
Büyük şirket arşivinde cevap bulabildiler mi?
Yaklaşık 254 bin karakterlik arşivde Gemma cevap yazamadı. LFM2.5 cevabını tamamladı ama on sorudan yalnızca birini tam doğru yanıtladı.
Küçük projeyi hangi model düzeltti?
Gemma dört hatayı da düzeltti. LFM2.5 üç hatayı düzeltti; para paylaştırma işlevindeki hata kaldı.
Bu test önceki Gemma–LFM karşılaştırmasıyla aynı mı?
Hayır. Önceki testte iki model aynı ayarlarda çalıştı. Burada her model kendi üreticisinin önerdiği ayarlarla çalıştı; iki testin sayılarını karşılaştırmıyoruz.
Hangi model daha kısa sürede bitirdi?
LFM2.5 beş bölümün dördünde daha kısa sürede durdu. Kod bölümünde Gemma 5 dakika 23 saniye, LFM2.5 10 dakika 16 saniye harcadı.
Testi kendi bilgisayarımda tekrarlayabilir miyim?
Evet. Görevler, puanlayıcılar, çalıştırma dosyaları ve ham cevaplar test deposunda bulunuyor. Kurulum ve çalıştırma adımları BASLAT.md dosyasında yer alıyor.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen lokal (yerel) yapay zekâ kurulumu.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
- yazılım
Özel Yazılım ve Web Uygulaması Geliştirme
Web uygulaması, özel işlev ve entegrasyon ihtiyaçlarınızı birlikte değerlendirelim.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.