12 dk okuma
Küçük Model Hızlı mı? Qwen3.5 ve Gemma 4
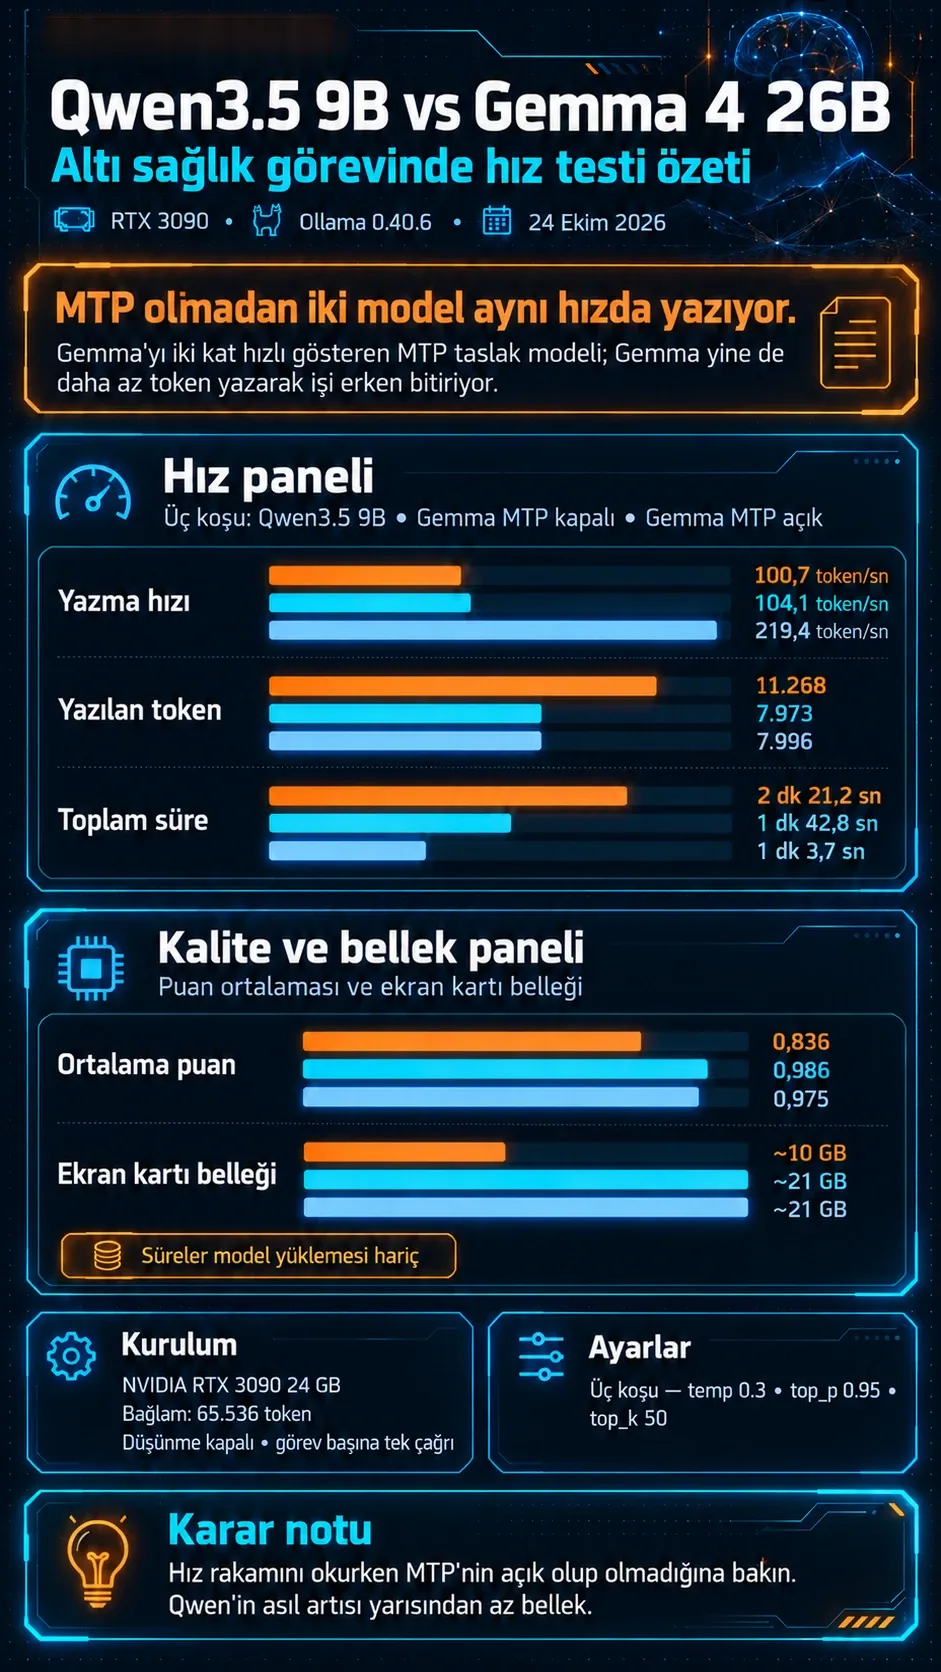
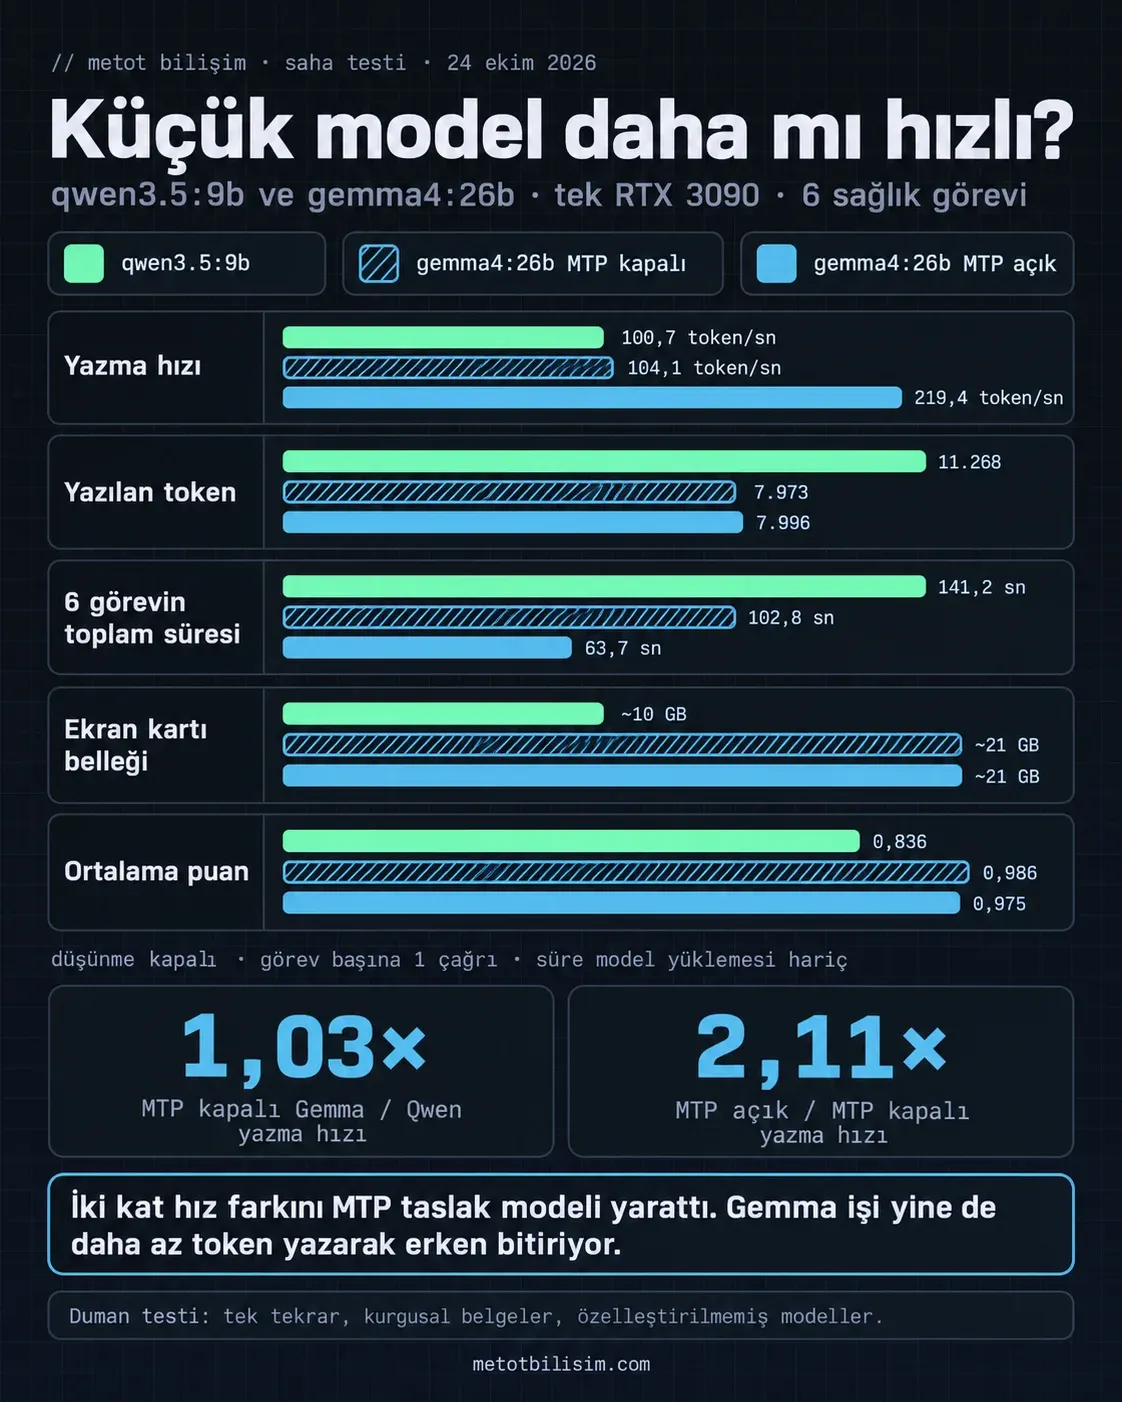
qwen3.5:9b ile gemma4:26b taslak model olmadan aynı hızda yazıyor: aynı altı sağlık görevinde 100,7'ye karşı 104,1 token/sn. Gemma'yı iki kat hızlı (219,4) gösteren MTP; Gemma yine de daha az token harcadığı için işi erken bitiriyor. Qwen'in kazancı, yarısından az bellek.
Abdullah KarakuşYayın: Güncelleme:
öne çıkanlar
- Taslak model olmadan iki model aynı hızda yazdı: aynı altı görevde qwen3.5:9b 100,7, MTP kapalı gemma4:26b 104,1 token/sn. MTP açıkken Gemma 219,4'e çıktı; hız farkının neredeyse tamamı MTP'den geliyor.
- Gemma işi yine de erken bitirdi: MTP kapalıyken bile 11.268'e karşı 7.973 token yazdı ve model yüklemesi hariç 141,2 sn'ye karşı 102,8 sn'de bitirdi; MTP açıkken 63,7 sn.
- Qwen'in artısı bellek ve metin okuma hızı: ekran kartında 9,7–10,0 GB'a karşı 20,5–21,4 GB tuttu, metin görevlerinde saniyede 3.971 token okudu (Gemma MTP kapalı 3.652, MTP açık 3.368).
Küçük model daha mı hızlı: testin kısa cevabı nedir?
#Hayır: taslak model olmadan qwen3.5:9b ile gemma4:26b aynı hızda yazdı; aynı altı sağlık görevinde ortalama 100,7’ye karşı 104,1 token/sn ölçtük. Gemma’yı iki kat hızlı gösteren şey MTP: Ollama paketindeki taslak modelle 219,4 token/sn’ye çıktı. Gemma yine de daha az token harcadığı için işi erken bitirdi; qwen3.5:9b’nin kazancı yarısından az bellek kullanması. Üç koşuyu 24 Ekim 2026’da tek RTX 3090’da, Gemma 4 sağlık kuruluşu testimizdeki altı görevle yaptık.
| Ölçüt | qwen3.5:9b | gemma4:26b, MTP kapalı | gemma4:26b, MTP açık |
|---|---|---|---|
| Yazma hızı, 6 görevin ortalaması | 100,7 token/sn | 104,1 token/sn | 219,4 token/sn |
| Çıktı token, 6 görev toplamı | 11.268 | 7.973 | 7.996 |
| Toplam süre, yükleme hariç | 141,2 sn | 102,8 sn | 63,7 sn |
| Puan ortalaması, 1 üzerinden | 0,836 | 0,986 | 0,975 |
| Ekran kartı belleği | 9,7–10,0 GB | 20,5–21,4 GB | 20,9–21,4 GB |
| Okuma hızı, görev 1–5 ortalaması | 3.971 token/sn | 3.652 token/sn | 3.368 token/sn |
Tüm ölçümler düşünme kapalıyken alındı. Gemma’nın iki puanı arasındaki fark tek çağrılık örnekleme farkıdır; bu ölçüm MTP’nin kaliteyi artırdığını ya da düşürdüğünü göstermez.
Düzeltme (24 Ekim 2026): Bu yazının ilk sürümü hız farkını Gemma’nın uzman karışımı (MoE) yapısına bağlıyordu. Gemma’yı MTP kapalı aynı altı görevde koşunca bunun yanlış olduğunu gördük ve yazıyı yeni ölçümle yeniden yazdık.
Düşünme açıkken tablo değişiyor: altı çağrıda Qwen birinde, MTP açık Gemma ikisinde, MTP kapalı Gemma üçünde döngüye girip cevapsız kaldı.
Test nasıl kuruldu?
#Aynı altı görevi Qwen’e ve Gemma’ya, aynı ayarlarla ve tek RTX 3090’da verdik; Gemma’yı MTP açık ve kapalı olmak üzere iki kez koştuk. Görevler bir sağlık kuruluşunun gündelik işlerini taklit ediyor; belgelerin hepsi kurgusal ve doğru cevaplar baştan belli. Tuzakları ve puan ölçütlerini Gemma yazısında anlattık; modelden istenen iş şu:
| Görev | Modelden istenen |
|---|---|
| Taslak epikriz | 14 belgelik yatış dosyasından (yaklaşık 11,6 bin token) 22 maddeyi çıkarmak, 7 tuzağa basmamak |
| İlaç-doz tutarlılığı | 64 kayıtta 6 çelişkiyi bulmak, 4 tuzağa alarm vermemek |
| Mesaj sınıflandırma | 40 hasta mesajını kategori, birim ve acil bayrağıyla ayırmak |
| Protokol araması | 9 protokol belgesinde 14 soruyu kaynak göstererek cevaplamak |
| Kişisel veri maskeleme | Yaklaşık 1.650 kelimelik metinde 42 kişisel veriyi maskelemek |
| Taranmış belge okuma | 5 belge görselinden altışar alan okumak |
Üç koşuda da şunlar aynıydı:
- Sıcaklık 0,3, top_p 0,95, top_k 50
- Bağlam penceresi 65.536 token, düşünme bütçesi 28.672 token
- Q4_K_M kuantizasyon (4 bit civarı ağırlık) ve Ollama 0.40.6
- Her görev ve mod için tek çağrı: bu bir duman testi
MTP açık Gemma, Ollama paketindeki taslak modelle yüklendi. MTP kapalı sürüm aynı ağırlıkları taşıyor; yalnızca Modelfile’daki DRAFT satırı çıkarıldı. Bu ayarlar Qwen’in önerdiği değerler değil; ayrıntısı testin sınırlarında.
Yazma hızı: iki model neden aynı hızda yazdı?
#Taslak model olmadan qwen3.5:9b ile gemma4:26b aynı hızda yazdı: aynı altı görevde 100,7’ye karşı 104,1 token/sn.
Taslak model olmadan Qwen ile Gemma her görevde aynı hızda yazdı
Yazma (üretim) hızı, token/sn. Düşünme kapalı, Gemma MTP kapalı.
- qwen3.5:9b
- gemma4:26b MTP kapalı
Taslak epikriz
İlaç-doz tutarlılığı
Mesaj sınıflandırma
Protokol araması
Kişisel veri maskeleme
Taranmış belge okuma
Tablo olarak göster
| Görev | qwen3.5:9b | gemma4:26b MTP kapalı |
|---|---|---|
| Taslak epikriz | 99,8 | 101,6 |
| İlaç-doz tutarlılığı | 101,9 | 104,2 |
| Mesaj sınıflandırma | 103,3 | 104,2 |
| Protokol araması | 98,4 | 103,7 |
| Kişisel veri maskeleme | 100,5 | 105,3 |
| Taranmış belge okuma | 100,4 | 105,5 |
Qwen her görevde saniyede 98 ile 103 token yazdı, MTP kapalı Gemma 102 ile 106 arasında kaldı. MTP açıkken aynı Gemma görevlere göre 205 ile 234 token/sn yazdı, ortalaması 219,4.
İki modelin yapısı farklı, ama bu fark yazma hızına yansımadı. gemma4:26b toplam 25,2 milyar parametreli bir uzmanlar karışımı (MoE) modeli. Ağı, uzman denen alt ağlara bölünmüş ve her token’da yalnızca birkaçı çalışıyor. Google’ın model kartına göre 128 uzmandan 8’i (artı 1 paylaşılan uzman) devreye giriyor; token başına çalışan parametre yaklaşık 3,8 milyar. qwen3.5:9b’yi yoğun (dense) model olarak ele aldık: model kartı her katmanda tek bir ileri besleme ağı tanımlıyor ve uzman sayısı vermiyor. Yani her token’da 9 milyar parametrenin tamamı çalışıyor.
| qwen3.5:9b | gemma4:26b | |
|---|---|---|
| Toplam parametre | 9,0 milyar | 25,2 milyar |
| Her token’da çalışan | 9 milyar, hepsi | yaklaşık 3,8 milyar |
| Yapı | Yoğun, 32 katman | Uzman karışımı, 30 katman |
| Ollama dosyası | 6,6 GB | 18 GB |
| Bağlam penceresi (model) | 262.144 token | 262.144 token |
Gemma’nın uzmanlarından her token’da yalnızca küçük bir kısmı çalışıyor:
gemma4:26b: her token’da 128 uzmandan 8’i çalışır
Token üretirken ekran kartı, çalışan ağırlıkları her adımda bellekten okur; NVIDIA bu aşamayı bellek bant genişliğiyle sınırlı bir işlem olarak tanımlıyor. RTX 3090’ın belleği en çok 936 GB/sn aktarıyor. Parametre başına 0,6 bayt civarı varsayarsak (kabaca hesap, ölçüm değil) Gemma token başına yaklaşık 2,3 GB, Qwen yaklaşık 5,5 GB okur.
| Model | Token başına okunan ağırlık | Bant genişliğinden üst sınır | Ölçtüğümüz hız |
|---|---|---|---|
| qwen3.5:9b | yaklaşık 5,5 GB | yaklaşık 170 token/sn | 100,7 token/sn |
| gemma4:26b | yaklaşık 2,3 GB | yaklaşık 400 token/sn | 104,1 token/sn (MTP kapalı), 219,4 token/sn (MTP açık) |
Ölçtüğümüz hızlar üst sınırların altında kaldı. Hesap Gemma için 2,4 kat avantaj öngörüyordu; MTP kapalıyken oran 1,03 çıktı (104,1’e karşı 100,7). MTP açıkken görünen 2,2 katı hesabın tutması saymıyoruz, çünkü o fark MTP’den geliyor. Hesabın neden tutmadığını araştırmadık.
Bellek: yarı yarıya tasarruf neye yarıyor?
#qwen3.5:9b ekran kartında 9,7–10,0 GB tuttu; gemma4:26b MTP açıkken 20,9–21,4 GB, MTP kapalıyken 20,5–21,4 GB.
gemma4:26b kartın neredeyse tamamını doldurdu, qwen3.5:9b yarısından azını
Ekran kartı belleği (GB). Dosya boyutu Ollama’nın model listesinden, kullanım nvidia-smi’den.
- qwen3.5:9b
- gemma4:26b MTP açık
- referans: kartın kapasitesi (24 GB)
Ollama dosyası
Çalışırken en düşük
Çalışırken en yüksek
Tablo olarak göster
| Ölçüm | qwen3.5:9b | gemma4:26b MTP açık |
|---|---|---|
| Ollama dosyası | 6,6 | 18 |
| Çalışırken en düşük | 9,7 | 20,9 |
| Çalışırken en yüksek | 10,0 | 21,4 |
Dosya boyutunun üstüne 65.536 token’lık bağlam penceresi ve çalışma alanı biniyor; iki modelde de bu ek yaklaşık 3 GB tuttu. Qwen’in yanında kartta yaklaşık 14 GB boş yer kalıyor: daha uzun bir bağlama ya da ikinci bir işe yer var. Gemma’nın yanında boşluk yaklaşık 3 GB. Boş yerin neye yeteceğini denemedik; kendi yükünüzle ölçmeniz gerekir.
Okuma hızı: Qwen’in öne geçtiği yer neresi?
#Metni okumada Qwen biraz daha hızlıydı: metin görevlerinde ortalama 3.971’e karşı 3.368 token/sn (MTP açık Gemma), yani yaklaşık %18. MTP kapalı Gemma 3.652 token/sn okudu; Qwen bu ölçümde de ortalamada önde.
Qwen metin okumada beş görevin dördünde önde, birinde eşit
Okuma (istem işleme) hızı, token/sn. Düşünme kapalı.
- qwen3.5:9b
- gemma4:26b MTP açık
Taslak epikriz
İlaç-doz tutarlılığı
Mesaj sınıflandırma
Protokol araması
Kişisel veri maskeleme
Taranmış belge okumagörsel
Tablo olarak göster
| Görev | qwen3.5:9b | gemma4:26b MTP açık |
|---|---|---|
| Taslak epikriz | 3.608 | 3.621 |
| İlaç-doz tutarlılığı | 4.150 | 3.439 |
| Mesaj sınıflandırma | 3.736 | 2.968 |
| Protokol araması | 4.285 | 3.645 |
| Kişisel veri maskeleme | 4.075 | 3.170 |
| Taranmış belge okuma (görsel) | 1.426 | 871 |
Aynı epikriz dosyasını Qwen 12.055, Gemma 11.646 token’a çevirdi. Belirteçleyiciler (tokenizer) farklı olduğu için sayılar birebir kıyaslanamaz, ama yaklaşık %3,5’lik fark %18’lik avantajı silmiyor.
Görsel görevde durum tersine döndü. Qwen beş belge görselini 9.077 istem token’ına çevirdi, Gemma 2.971’e. Qwen okuma hızında yine önde (1.426’ya karşı 871 token/sn), ama istem üç kat uzun olduğu için görev 15,53 sn’ye karşı 8,58 sn sürdü.
Aynı işi bitirmek için kim kaç token harcadı?
#Qwen altı görevde toplam 11.268 çıktı token’ı yazdı, MTP kapalı Gemma 7.973 (MTP açık Gemma 7.996); yani Qwen aynı iş için 1,41 kat daha fazla token harcadı.
Qwen her görevde Gemma’dan çok yazdı, en büyük fark epikrizde
Görev başına çıktı token’ı. Düşünme kapalı.
- qwen3.5:9b
- gemma4:26b MTP kapalı
Taslak epikriz
İlaç-doz tutarlılığı
Mesaj sınıflandırma
Protokol araması
Kişisel veri maskeleme
Taranmış belge okuma
Tablo olarak göster
| Görev | qwen3.5:9b | gemma4:26b MTP kapalı |
|---|---|---|
| Taslak epikriz | 2.127 | 724 |
| İlaç-doz tutarlılığı | 618 | 401 |
| Mesaj sınıflandırma | 1.888 | 1.374 |
| Protokol araması | 1.750 | 1.024 |
| Kişisel veri maskeleme | 4.233 | 3.889 |
| Taranmış belge okuma | 652 | 561 |
Qwen, Gemma ile aynı hızda yazdığı hâlde işi 1,37 kat geç bitirdi: model yüklemesi hariç toplam 141,2 sn’ye karşı 102,8 sn (MTP kapalı). Süre farkı hızdan değil, 1,41 kat fazla token’dan geliyor. MTP açık Gemma aynı işi 63,7 sn’de bitirdi; Qwen’den iki kattan fazla erken. Modelin diskten yüklenmesi yalnızca ilk çağrıda oldu (MTP açık Gemma 8,2 sn, Qwen 3,3 sn); yükleme dahil süreler 144,6 ve 72,0 sn.
Puanda da Qwen geride kaldı: ortalama 0,836’ya karşı MTP kapalı Gemma’da 0,986, MTP açık Gemma’da 0,975. Gemma’nın iki değeri arasındaki fark tek çağrılık örnekleme farkıdır; bu ölçüm MTP’nin kaliteyi değiştirip değiştirmediğini göstermez. Qwen’in geride kaldığı fark iki görevde toplandı; aşağıdaki grafik MTP açık Gemma’yı gösteriyor.
Qwen iki görevde belirgin geride kaldı: ilaç-doz kontrolü ve protokol araması
Görev puanı (1 üzerinden). Düşünme kapalı.
- qwen3.5:9b
- gemma4:26b MTP açık
Taslak epikriz
İlaç-doz tutarlılığı
Mesaj sınıflandırma
Protokol araması
Kişisel veri maskeleme
Taranmış belge okuma
Tablo olarak göster
| Görev | qwen3.5:9b | gemma4:26b MTP açık |
|---|---|---|
| Taslak epikriz | 0,872 | 1,000 |
| İlaç-doz tutarlılığı | 0,667 | 0,857 |
| Mesaj sınıflandırma | 1,000 | 1,000 |
| Protokol araması | 0,643 | 1,000 |
| Kişisel veri maskeleme | 0,865 | 0,994 |
| Taranmış belge okuma | 0,967 | 1,000 |
İlaç-doz kontrolünde Qwen 6 çelişkiden 5’ini doğru türle yazdı, birinin türünü karıştırdı ve 3 yanlış alarm verdi. Protokol aramasında 8 cevaplanabilir sorunun 5’inde cevabı eksik ya da yanlış yazdı; eski revizyondan aldığı bir cevap da oldu. Öte yandan arşivde olmayan 3 soruda “bulunamadı” dedi, 3 kapsam dışı soruyu işaretledi ve 14 alıntının hiçbirini uydurmadı. Qwen cevap uydurmadı, ama doğru cevabı da her seferinde bulamadı. Nedenini incelemedik.
Düşünme açıkken tablo nasıl değişti?
#- tekrarda MTP açık Gemma altı görevin ikisinde (protokol araması ve maskeleme) cevap yazamadan döngüye girdi, Qwen birinde (ilaç-doz kontrolü). MTP kapalı Gemma altı çağrının üçünde döngüye girdi.
Düşünme açık, 1. tekrar: 6 çağrının sonu
Cevap yazıldı ya da model kendini tekrarlayıp döngüye girdi ve çağrı kesildi.
- Cevap yazıldı
- Döngüyle kesildi
qwen3.5:9b
gemma4:26b MTP açık
Tablo olarak göster
| Model | Cevap yazıldı | Döngüyle kesildi |
|---|---|---|
| qwen3.5:9b | 5 | 1 |
| gemma4:26b MTP açık | 4 | 2 |
Qwen’in ilaç-doz kaydında aynı dört satır sürekli dönüyor: Wait, check H01 Ramipril O19 vs R02. Kayıtta “Wait” 98 kez geçiyor. Model yaklaşık 12,1 bin token düşündükten sonra 137,4 sn’de kesildi (token sayısı yaklaşık). Gemma’nın sağlık testinde gördüğümüz döngüleri de buna benziyordu.
Düşünme açıkken bitirilen görevlerde Qwen, MTP açık Gemma’dan yavaştı; her ikisi de döngüye takıldı
Çağrı süresi (sn), 1. tekrar. “döngü”: model kendini tekrar etti, çağrı cevapsız kesildi. Süreler model yüklemeyi içerir (Gemma’nın epikriz çağrısında 14,2 sn).
- qwen3.5:9b
- gemma4:26b MTP açık
Taslak epikriz
İlaç-doz tutarlılığı
Mesaj sınıflandırma
Protokol araması
Kişisel veri maskeleme
Taranmış belge okuma
Tablo olarak göster
| Görev | qwen3.5:9b | gemma4:26b MTP açık |
|---|---|---|
| Taslak epikriz | 117,7 | 60,0 |
| İlaç-doz tutarlılığı | döngü | 52,5 |
| Mesaj sınıflandırma | 83,0 | 50,1 |
| Protokol araması | 95,2 | döngü |
| Kişisel veri maskeleme | 141,4 | döngü |
| Taranmış belge okuma | 22,8 | 18,0 |
Qwen tamamladığı 5 görevde 0,967–1,00 aldı. Gemma’nın döngüye girdiği protokol aramasını ve maskelemeyi ikisinde de 1,00 ile bitirdi. Bu umut verici, ama 6 çağrıdan oran çıkmaz: Gemma’nın 3 tekrarlık tam koşusunda düşünme açık 18 çağrının 7’si döngüye girmişti, Qwen için o sayıyı ölçmedik.
İkisinin de bitirdiği üç görevde (epikriz, mesaj sınıflandırma, taranmış belge) toplam çıktı neredeyse aynıydı: Qwen 21.250, Gemma 21.055 token. Süre 223,5 sn’ye karşı 128,1 sn çıktı. Gemma’nın süresinde 14,2 sn’lik yükleme var; çıkarınca 113,8 sn kalır.
MTP kapalı Gemma’nın düşünme açık tamamladığı üç çağrıda (ilaç-doz, mesaj sınıflandırma, taranmış belge) yazma hızı ortalama 103,2 token/sn oldu; üçü de 1,000 puan aldı. Aynı koşuda MTP açık Gemma 212, Qwen 98,5 token/sn yazmıştı. Altı çağrıdaki üç döngüden oran çıkarılamaz.
Bu test ne kadar sağlam?
#Model seçerken neye bakmalı?
#Model seçerken hız rakamının MTP gibi bir taslak modelle alınıp alınmadığına, işi bitirmek için harcanan token’a ve doğru cevap başına süreye bakın; dosya boyutu ya da parametre sayısı bunları tek başına söylemez.
Taslak model ve çıktı türü:
Taslak model olmadan iki model aynı hızda yazdı (100,7’ye karşı 104,1 token/sn); MTP Gemma’yı 219,4’e çıkardı. Bir hız rakamı gördüğünüzde modelin taslak modelle çalışıp çalışmadığını ve ne tür çıktı ürettiğini sorun.
İşi bitirmek için harcanan token:
Qwen aynı altı görevde 1,41 kat daha çok token yazdı. Hız aynı olduğu için bu fark doğrudan süreye yansıdı: 141,2 sn’ye karşı 102,8 sn.
Doğru cevap başına süre:
Model yüklemesi hariç Qwen 141,2 sn’de 0,836, MTP kapalı Gemma 102,8 sn’de 0,986, MTP açık Gemma 63,7 sn’de 0,975 puan aldı. Hız tek başına bir şey söylemez.
Bu kartta qwen3.5:9b hız kazandırmıyor: taslak model olmadan Gemma ile aynı hızda yazıyor, ama daha çok token harcadığı için işi geç bitiriyor. Kazancı bellekte: aynı kartta daha uzun bir bağlama ya da yanında başka bir işe yer bırakıyor. Düşünme açıkken daha az döngüye girmesi umut verici, ama bunu sağlam bir sonuca çevirmek için her görevi birkaç kez koşmak gerekir.
Hangi modelin sizin belgelerinizde nasıl davrandığını kendi örnek belgelerinizle ölçerek görürsünüz. Yerel yapay zekâ kurulumunda bu ölçümü kuruluşun kendi belgeleriyle ve doğru cevabı baştan bilinen görevlerle yapıyoruz; kapsamı ve güvenceleri sağlık kuruluşları için yerel yapay zekâ kurulumu sayfasında anlattık.
Bu testi kendim nasıl tekrarlarım?
#Qwen3.5 9B’nin kayıtları Gemma’nın sağlık testiyle aynı depoda; depoyu klonlayıp README’deki komutları izlemeniz yeterli.
// açık test verisi
- kod · MIT
- veri · CC BY 4.0
metotbilisim/yerel-yz-saglik-testi
github.com
Qwen kıyasının kayıtları Gemma’nın sağlık testiyle aynı depoda ve açık
Bu yazıdaki Qwen sonuçları yerel-yz-saglik-testi deposunda, results/smoke-qwen35-9b klasöründe duruyor. MTP kapalı Gemma sonuçları results/smoke-gemma-nomtp klasöründe; üç koşuyu yan yana koyan KARSILASTIRMA.md de orada.
Kıyas bir duman testi: her görev ve mod için tek çağrı. Döngüye giren Qwen çağrısı da kayıtlı, yani tek tekrarlık hücrelerden ne çıkarılıp ne çıkarılamayacağını kayıtlara bakarak kendiniz değerlendirebilirsiniz.
// depoda neler var
Sağlık seti:
Epikriz, ilaç tutarlılığı, mesaj sınıflandırma, protokol arşivi, maskeleme ve taranmış belge okuma görevleri.
Qwen kayıtları:
qwen3.5:9bile alınan 12 çağrının cevabı, düşünme metni ve puan dökümü.Gemma kayıtları:
MTP açık Gemma’nın duman ve tam koşu kayıtları ile MTP kapalı koşu (
results/smoke-gemma-nomtp) aynı depoda.Koşucu:
run_sector.py,--model qwen3.5:9bseçeneğiyle aynı görevleri Qwen’e verir; ayarlar iki modelde aynıdır.Kıyas notu:
KARSILASTIRMA.md, hız ve token rakamlarının hangi kayıtlardan alındığını yazar; MTP kapalı sürümModelfile.nomtpile kuruldu.
git clone https://github.com/metotbilisim/yerel-yz-saglik-testi.gitKullanırken kaynak olarak Metot Bilişim (metotbilisim.com) belirtmeniz yeterli.
Kaynaklar
#- Qwen3.5-9B model kartı — Hugging Face (Qwen)huggingface.co
- qwen3.5 — Ollamaollama.com
- Gemma 4 model kartı — Google AIai.google.dev
- GeForce RTX 3090 ve 3090 Ti — NVIDIAnvidia.com
- NVIDIA GeForce RTX 3090 Review — HotHardwarehothardware.com
- Mastering LLM Techniques: Inference Optimization — NVIDIA Teknik Blogdeveloper.nvidia.com
yazar
Abdullah Karakuş
Dijital Pazarlama Yöneticisi
Abdullah Karakuş, dijital pazarlama ve web teknolojileri alanında 10 yılı aşkın deneyime sahiptir. SEO, GEO, Google Ads, Meta Ads ve web teknolojileri üzerine uzmanlaşmıştır. Yazılım geliştirme geçmişini veri analizi ve performans pazarlaması deneyimiyle birleştirerek dijital görünürlük stratejileri geliştirir. Metot Bilişim'de teknik SEO, içerik optimizasyonu, reklam performansı ve web projelerinin stratejik süreçlerini yönetir.
- seo
- geo
- ads
- web
Bu sayfa en son güncellendi.
sss
Sıkça sorulan sorular
Burada cevabını bulamadığınız bir soru varsa doğrudan ekibimize sorabilirsiniz.
Sorunuzu bize iletinKüçük yapay zekâ modeli her zaman daha hızlı mıdır?
Hayır. Testimizde 9 milyar parametreli qwen3.5:9b, 25,2 milyar parametreli gemma4:26b'nin yarısından az bellek kullandı (9,7–10,0 GB'a karşı 20,5–21,4 GB) ama hızda öne geçmedi. Düşünme kapalıyken, taslak model olmadan iki model aynı hızda yazdı (100,7'ye karşı 104,1 token/sn). MTP açıkken Gemma 219,4'e çıktı. Gemma ayrıca daha az token harcadığı için işi daha erken bitirdi.
gemma4:26b neden qwen3.5:9b'den iki kat hızlı yazdı?
MTP yüzünden. Gemma, Ollama paketindeki 0,46 GB'lık MTP taslak modeliyle yüklendi; taslak her adımda en çok 3 token öneriyor, ana model bunları tek adımda doğruluyor. Görevler JSON çıktısı verdiği için öneriler neredeyse hep tuttu (kabul %99,7). Aynı altı görevde MTP kapalı Gemma 104,1, MTP açık Gemma 219,4 token/sn yazdı: oran 2,11. MTP kapalı Gemma ile Qwen arasındaki oran 1,03 kaldı (104,1'e karşı 100,7). Bant genişliği hesabı MoE için 2,4 kat avantaj öngörüyordu; bu avantaj ölçümde görünmedi, nedenini araştırmadık.
RTX 3090'da qwen3.5:9b saniyede kaç token yazar?
Düşünme kapalıyken altı sağlık görevinde ortalama 100,7 token/sn; görevlere göre 98,4 ile 103,3 arasında. Düşünme açıkken ortalama 98,5 token/sn. gemma4:26b aynı kartta düşünme kapalıyken 104,1 (MTP kapalı) ve 219,4 (MTP açık) token/sn yazdı. Düşünme açıkken MTP açık Gemma 212 token/sn yazdı; MTP kapalı Gemma'nın tamamladığı görevlerde ortalama 103,2. Bunlar tek çağrılık duman testinin değerleridir; tek kart ve tek kullanıcıyla ölçtük.
qwen3.5:9b ile gemma4:26b hangisi daha az ekran kartı belleği kullanır?
qwen3.5:9b. Ollama dosyası 6,6 GB; 65.536 token'lık bağlamla kartta 9,7–10,0 GB tuttu. gemma4:26b dosyası 18 GB; kartta MTP açıkken 20,9–21,4 GB, kapalıyken 20,5–21,4 GB tuttu. 24 GB'lık RTX 3090'da Qwen'in yanında yaklaşık 14 GB boş yer kalıyor, Gemma'nın yanında yaklaşık 3 GB.
Düşünme açıkken hangi model daha az döngüye girer?
Testimizde Qwen 6 görevin 1'inde, MTP açık Gemma 2'sinde, MTP kapalı Gemma 3'ünde döngüye girip cevapsız kaldı. Her görev için tek çağrı koştuğumuzdan bu oranlar güvenilir değil: Gemma'nın 3 tekrarlık tam koşusunda düşünme açık 18 çağrının 7'si döngüye girmişti, Qwen için bu sayıyı ölçmedik. Qwen'in döngü kaydı aynı dört ilaç-doz satırını tekrar tekrar yazıyordu.
Qwen3.5 9B sağlık kuruluşu görevlerinde Gemma 4 kadar doğru mu?
Düşünme kapalıyken değil: altı görevin puan ortalaması 0,836'ya karşı 0,986 (MTP kapalı Gemma) ve 0,975 (MTP açık Gemma). Qwen ilaç-doz tutarlılığında 0,667 (MTP açık Gemma 0,857), protokol aramasında 0,643 (Gemma 1,000) aldı. Düşünme açıkken Qwen'in tamamladığı 5 görev 0,967–1,000 aldı. Belgeler kurgusaldı; tanı, tedavi ve triyaj isabetini ölçmedik.
Yerel model seçerken hangi ölçütlere bakmalı?
Dosya boyutu ya da parametre sayısı yerine üç şeye bakın: hız rakamının MTP gibi bir taslak modelle alınıp alınmadığı, işi bitirmek için harcanan token ve doğru cevap başına süre. Testimizde Qwen aynı altı görevde MTP kapalı Gemma'dan 1,41 kat daha çok token yazdı (11.268'e karşı 7.973). İşi de 1,37 kat geç bitirdi: model yüklemesi hariç 141,2 sn'ye karşı 102,8 sn, MTP açık Gemma ise 63,7 sn. Kendi belgelerinizle ölçmeden karar vermeyin.
Bu test kesin bir model sıralaması mı?
Hayır, duman testi: her görev ve mod için tek çağrı koştu. Tek RTX 3090, kurgusal belgeler, özelleştirilmemiş modeller ve üç koşuda aynı ayarlar (sıcaklık 0,3, top_k 50) kullandık; bu ayarlar Qwen'in önerdiği değerler değil. Sonucu ilk ölçüm olarak okuyun.
ilgili hizmetler
İlgili hizmetler
- yerel yapay zekâ
Yerel Yapay Zekâ Kurulumu
Müvekkil, hasta ve finansal verilerinizi kurumunuzda işleyen lokal (yerel) yapay zekâ kurulumu.
- yerel yapay zekâ
Sağlık Kuruluşları İçin Yerel Yapay Zekâ Kurulumu
Hasta dosyalarını ve idari belgeleri kurumunuzun kendi sunucusunda işleyen yerel yapay zekâ kurulumu: erişim ayrımı, HBYS, kayıtlar ve belgelerinizle pilot.
- yapay zekâ
İşletmeler İçin Yapay Zekâ Danışmanlığı
İşletmeniz için yapay zekâ danışmanlığı, Local AI kurulumu ve iş akışı otomasyonu.
blogdan
İlgili yazılar
- yerel yapay zekâ
10 dk okuma
Lokal Yapay Zekâ Kurulumu: Adım Adım Rehber
Lokal yapay zekâ kurulumu, açık ağırlıklı bir dil modelini Ollama veya LM Studio gibi bir araçla kendi bilgisayarınızda ya da sunucunuzda çalıştırmaktır. Kişisel denemede birkaç adım yeter; ekibe açılacak kurulumda yetki, belge erişimi, kayıt ve güncelleme de planlanır.
- yerel yapay zekâ
8 dk okuma
Lokal Yapay Zekâ Sunucusu: Hangi Donanım?
Lokal yapay zekâ sunucusunda belirleyici bileşen, modelin ve bağlamın sığması gereken ekran kartı belleğidir (VRAM). Testimizde 24 GB'lık tek RTX 3090, qwen3.5:9b'yi 9,7–10,0 GB, gemma4:26b'yi 20,5–21,4 GB kart belleğiyle çalıştırdı; hız farkını model boyutundan çok MTP belirledi.
- yerel yapay zekâ
11 dk okuma
Şirket İçi Yapay Zekâ Asistanı Kurulumu: Kendi Belgelerinizle
Şirket içi yapay zekâ asistanı, yerel bir dil modelini kurum belgelerinde arama yapan RAG katmanı ve rol bazlı yetkilerle birleştirir; sorular ve belgeler kurum ağında işlenir. Kurulumda modelden çok veri akışı, erişim sınırları ve kendi belgelerinizle yapılan pilot belirleyicidir.
Sizin İşletmeniz İçin Nereden Başlayalım?
Yeni bir site hazırlamak, mevcut sitenizi geliştirmek veya reklam çalışmalarınızı düzenlemek isteyebilirsiniz. İhtiyacınızı dinleyelim, yapılacak işleri ve uygun başlangıcı birlikte belirleyelim.